การสื่อสารของลิงก์เลเยอร์
Data Link Layer ต้องตอบสองคำถาม — "ผู้รับจะรู้ได้ยังไงว่าเฟรมเริ่มตรงไหนจบตรงไหน" (framing: async/sync, byte stuffing, bit stuffing) และ "หลายคนจะใช้สายเส้นเดียวร่วมกันได้ยังไง" (multiplexing: FDM, TDM, WDM, Stat-MUX)
บทนี้ป้อนข้อสอบ 2 ข้อ และทั้งสองข้อเป็นข้อ "ทำได้แน่ถ้าจำสูตร/กติกาได้":
- Q2 — TDM Multiplexing : โจทย์ให้จำนวนแหล่ง, อัตราของแต่ละแหล่ง, ขนาดสล็อต และจำนวน sync bit แล้วให้หา เวลาที่ใช้ส่ง 1 บิต (10 µs), ขนาดเฟรม (21 บิต) และ อัตราของลิงก์ (2.1 Mbps — ต้องนับ sync bit ด้วย) → ดู หัวข้อ 10.3.2
- Q11 ข้อ b — Bit Stuffing : ให้สตริงบิตมา แล้วให้เขียนบิตที่ส่งจริงออกมาหลังทำ bit stuffing (flag =
01111110) → ดู หัวข้อ 10.2
10.0Data Link Layer ทำอะไร
Data Link Layer ทำหน้าที่สนับสนุนการสื่อสารระหว่างโนดกับโนด (node-to-node) ทั้งแบบ point-to-point และ point-to-multipoint เนื่องจากเลเยอร์นี้ได้รับผลจากสายสัญญาณโดยตรง จึงมีโอกาสเกิดความผิดพลาดค่อนข้างมากจากสัญญาณรบกวนต่าง ๆ โนดในเลเยอร์นี้จึงต้องรองรับความผิดพลาดที่อาจเกิดขึ้นและแก้ไขให้ได้ แม้ว่าจะต้องส่งใหม่ก็ตาม
ขั้นตอนการทำงานฝั่งส่ง:
- แปลงข้อมูลให้อยู่ในรูปดิจิทัล
- เพิ่มเฮดเดอร์ เช่น MAC address ของภาครับและภาคส่ง
- เพิ่มส่วนท้าย (trailer) เพื่อใช้ตรวจสอบความผิดพลาด
- ทั้งหมดกลายเป็น เฟรม (frame) แล้วส่งต่อลงไปยัง Physical Layer
ฝั่งรับทำย้อนกลับ — รับเฟรม → นำเฮดเดอร์ออก → ตรวจสอบข้อผิดพลาดที่อาจเกิดระหว่างการสื่อสาร → ส่งขึ้นไปเลเยอร์ถัดไป
การสื่อสารแบบประสานเวลา (Synchronous) และไม่ประสานเวลา (Asynchronous) · การจัดการเฟรม · การทำมัลติเพล็กซิง · สวิตชิ่ง · การตรวจสอบข้อผิดพลาด · การควบคุมการส่งผ่านข้อมูล — บทนี้ครอบ 3 หัวข้อแรก ส่วนการตรวจสอบข้อผิดพลาดอยู่บทที่ 12 และการควบคุมการส่งผ่านอยู่บทที่ 11
10.1การส่งข้อมูลแบบอะซิงโครนัสและแบบซิงโครนัส
การส่งข้อมูลในเน็ตเวิร์กโดยทั่วไปแบ่งออกได้เป็นสองประเภท คือ อะซิงโครนัส (Asynchronous — ไม่ประสานเวลา) และซิงโครนัส (Synchronous — ประสานเวลา)
| เทียบกัน | อะซิงโครนัส (Asynchronous) | ซิงโครนัส (Synchronous) |
|---|---|---|
| ใส่ตัวคั่นให้กับ | แต่ละอักขระ | ทั้งชุดข้อมูล (เฟรม) |
| ตัวคั่นคืออะไร | start bit + stop bit (+ parity bit) | flag ขนาด 8 บิต (1 ไบต์) หัวและท้าย |
| สัญญาณนาฬิกา | ไม่ต้องตรงกัน — ผู้รับตื่นเมื่อเห็น start bit | ต้องประสานเวลากัน (Synchronize) |
| โอเวอร์เฮด | สูง (ทุกอักขระโดนบวก 2–3 บิต) | ต่ำ (บวกครั้งเดียวต่อทั้งเฟรม) |
| เหมาะกับ | ข้อมูลน้อย ๆ, ราคาถูก, ง่าย | ข้อมูลขนาดใหญ่ ประสิทธิภาพสูง |
| ตัวอย่างจริง | RS-232 / COM1 | T-1, SONET |
10.1.1อะซิงโครนัส (Asynchronous)
ในสภาวะปกติช่องสัญญาณจะอยู่ในสถานะไม่มีข้อมูล (idle) เพื่อรอจนกระทั่งได้รับบิตเริ่มต้น (start bit) จึงจะเริ่มการทำงานของภาครับ
ตัวอย่างการสื่อสารแบบอะซิงโครนัสคือ RS-232 หรือที่เรียกกันทั่วไปว่า COM1 (อาจเป็นหมายเลขอื่นตามที่กำหนดไว้) ซึ่งเป็นการสื่อสารแบบอนุกรมของคอมพิวเตอร์ การส่งข้อมูลแต่ละอักขระประกอบด้วย
- บิตเริ่มต้น (start bit) — ตัวปลุกภาครับ
- ข้อมูลของอักขระ — ครั้งละ 5 ถึง 8 บิต
- บิตตรวจสอบความผิดพลาด (parity bit)
- บิตสิ้นสุด (stop bit)
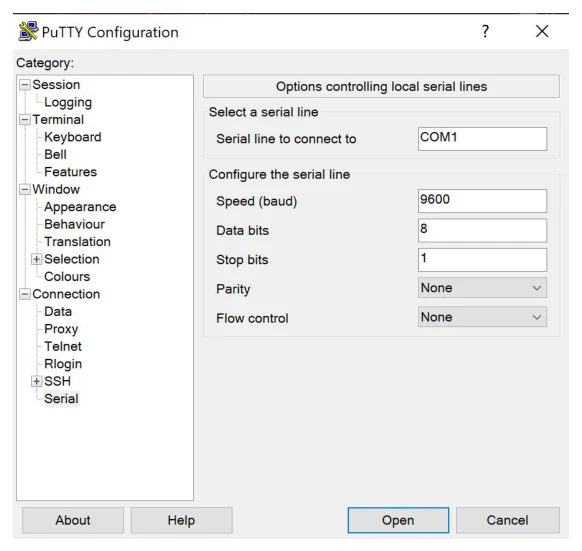
อ่านรูปนี้ยังไง
ทุกช่องในกล่อง Configure the serial line คือตัวแปรของเฟรมอะซิงโครนัส 1 อักขระ ที่ต้องตั้งไว้ล่วงหน้า:
Serial line= COM1 — ชื่อพอร์ต RS-232 ที่หนังสือพูดถึงพอดีSpeed (baud)= 9600 — อัตราบิตบนสายData bits= 8 — อยู่ในช่วง 5–8 บิต ตามที่หนังสือระบุStop bits= 1 — บิตสิ้นสุดParity= None — ตัวอย่างนี้ปิด parity bit ไว้Flow control= None
ค่าทั้ง 5 ช่องในรูปที่ 10.1 ไม่ได้ถูกส่งไปบอกอีกฝั่ง ไม่มีเฮดเดอร์ไหนพกมันไปด้วย ทั้งสองฝั่งจึงต้องตั้งให้ตรงกันเอง ถ้าเราตั้ง 9600 แต่อีกฝั่งตั้ง 19200 ภาครับจะสุ่มตัวอย่างสัญญาณผิดจังหวะแล้วอ่านออกมาเป็นตัวอักษรขยะทั้งหมด — นี่คือราคาของการ "ไม่ประสานเวลา" คือ start bit บอกได้แค่ว่า "เริ่มแล้ว" แต่บอกไม่ได้ว่า "เร็วแค่ไหน"
เพื่อหลีกเลี่ยงปัญหาที่อาจเกิดขึ้นจากการส่งวิธีนี้ ภาคส่งจะส่งข้อมูลที่ไม่ยาวเกินไป คือส่งครั้งละอักขระ อักขระละ 5–8 บิตเท่านั้น
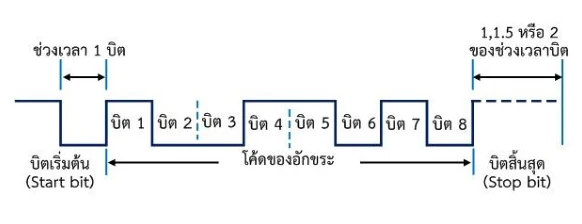
ในสาย RS-232 จริง ระดับแรงดันจะกลับด้านจากตรรกะปกติ (logic 1 = แรงดันลบ, logic 0 = แรงดันบวก) แต่รูปแบบเฟรมยังเหมือนเดิมทุกอย่าง ในการสอบให้ตอบตามโครงเฟรมพอ ไม่ต้องกังวลเรื่องขั้วแรงดัน
ข้อดี–ข้อเสียของอะซิงโครนัส
ข้อดี
- สะดวก
- ง่าย
- ค่าใช้จ่ายไม่สูง
ข้อเสีย
- สิ้นเปลืองโอเวอร์เฮด
- ไม่เหมาะกับการส่งข้อมูลขนาดใหญ่
- การส่งแบบซิงโครนัสมีประสิทธิภาพดีกว่า
ลองคิดเลข: ส่งอักขระ 8 บิต + start 1 + parity 1 + stop 1 = 11 บิตบนสาย ต่อข้อมูลจริง 8 บิต → โอเวอร์เฮด 3/11 ≈ 27% ถ้าส่งข้อมูล 1,000 อักขระก็เสียไปฟรี ๆ 3,000 บิต นี่คือความหมายของคำว่า "สิ้นเปลืองโอเวอร์เฮด" ในหนังสือ — เทียบกับซิงโครนัสที่บวก flag แค่ 2 ไบต์ต่อทั้งเฟรม
10.2แบบซิงโครนัส (Synchronous) และการทำ Framing
การส่งข้อมูลแบบซิงโครนัส อุปกรณ์ที่รับส่งข้อมูลต้องประสานเวลากัน (Synchronize) หมายถึงสัญญาณนาฬิกาของระบบต้องทำงานพร้อมกัน สัญญาณนาฬิกานี้ให้บริการกับอุปกรณ์หลักต่าง ๆ ในเน็ตเวิร์ก โดยภาครับจะใช้สัญญาณนาฬิกาเพื่อระบุขอบเขตของเฟรมที่รับได้
เพราะต้องประสานนาฬิกากัน การทำงานแบบซิงโครนัสจึงทำได้ดีในระยะทางที่ไม่ไกลมาก — ไกลเกินไปจะเกิดความผิดพลาดของสัญญาณนาฬิกา แนวทางแก้คือ ส่งสัญญาณนาฬิการ่วมไปกับข้อมูล (embed the clocking) เช่น การเข้ารหัสแบบ แมนเชสเตอร์ ในระบบดิจิทัล (ดูบทที่ 7) หรืออาศัยเฟสของคลื่นพาห์ (carrier) ในระบบอนาล็อก
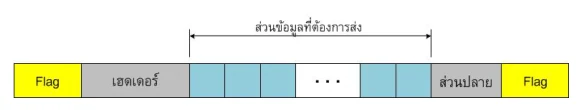
เพื่อให้ทราบจุดเริ่มต้นของข้อมูล ภาคส่งจะเพิ่มส่วนเริ่มต้นและสิ้นสุดให้กับชุดข้อมูลทั้งชุด แทนที่จะเพิ่มให้แต่ละอักขระเหมือนอะซิงโครนัส โดยทั่วไปตัวคั่นนี้คือ flag ขนาด 8 บิต หรือ 1 ไบต์ เมื่อภาครับได้รับข้อมูลจะตรวจหา flag นี้เพื่อระบุจุดเริ่มต้นและจุดสิ้นสุดของข้อมูล
ระหว่าง flag ทั้งสองอาจมีข้อมูลอื่น ๆ เช่น หมายเลขลำดับของข้อมูล หรือบิตตรวจสอบความผิดพลาด ตัวอย่างการส่งแบบซิงโครนัสได้แก่ การสื่อสารแบบ T-1 และ โซเน็ต (SONET)
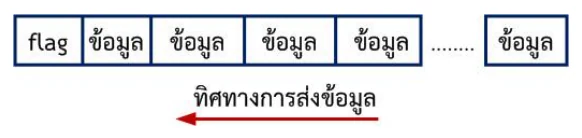
เทียบสองรูปให้เห็นภาพชัด ๆ: รูปที่ 10.2 (อะซิงโครนัส) ต้องแปะ start/stop ให้ทุกอักขระ แต่รูปที่ 10.3 (ซิงโครนัส) มี flag แค่ก้อนเดียวสำหรับข้อมูลทั้งชุด — นี่คือเหตุผลทั้งหมดที่หนังสือบอกว่าซิงโครนัสมีประสิทธิภาพดีกว่า
การสื่อสารแบบประสานเวลาแบ่งได้เป็นสองแบบ:
Character-oriented
ใส่อักขระพิเศษที่ไบต์เริ่มต้นและสิ้นสุดของข้อมูล (คือ flag ระบุที่ไบต์แรกและไบต์สุดท้ายของเฟรม) → แก้ปัญหาชนกันด้วย byte stuffing
Bit-oriented
ทำงานแบบเดียวกันแต่ในระดับบิต โดยเพิ่มค่า 01111110 ที่จุดเริ่มต้นและสิ้นสุดของเฟรม → แก้ปัญหาชนกันด้วย bit stuffing
Character-oriented + Byte Stuffing
ปัญหา: เราไม่สามารถหลีกเลี่ยงกรณีที่ข้อมูลที่จะส่งมีไบต์ที่มีค่าเดียวกับอักขระพิเศษ (Flag) ได้ ถ้าปล่อยไว้ ภาครับจะเข้าใจผิดว่าเฟรมจบตรงกลางข้อมูล
วิธีแก้ Byte stuffing:
- เมื่อพบว่าข้อมูลที่จะส่งมีไบต์ Flag อยู่ภายใน → ภาคส่งแทรกไบต์
ESCไว้ก่อนหน้าไบต์ Flag ทุกครั้ง (ได้เป็น ESC-Flag) - แต่ข้อมูลก็อาจมีไบต์
ESCอยู่ด้วยเหมือนกัน! ถ้าปล่อยไว้ ภาครับจะกำจัด ESC ผิดตัว → ภาคส่งจึงแทรก ESC ก่อนหน้าไบต์ ESC อีกหนึ่งไบต์ (ได้เป็น ESC-ESC) - ภาครับเมื่อได้รับเฟรม ถ้าพบ
ESCจะดึงออกจากเฟรม แล้วรับไบต์ถัดไปเป็นข้อมูลตรง ๆ → ได้ข้อมูลเดิมกลับมาครบ
ตัวอย่างเดียวกันในตำรา — รูปที่ 10.5 (ฝั่งส่ง) และรูปที่ 10.6 (ฝั่งรับ)
ภาพเคลื่อนไหวด้านบนเดินทีละสเต็ปด้วยข้อมูลสมมุติ A · FLAG · B · ESC · C เพื่อให้เห็นกลไก ส่วนสองรูปข้างล่างคือตัวอย่างเดียวกันที่วาดไว้ในตำรา ซึ่งวาดเป็นเฟรมเต็ม (มีเฮดเดอร์และส่วนปลายด้วย) — รูปซ้ายดูว่าฝั่งส่ง "เติม" อะไรเข้าไป · รูปขวาดูว่าฝั่งรับ "ถอด" อะไรออก
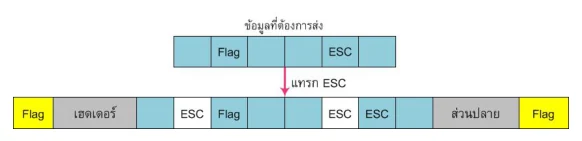
ESC ทั้งหน้า Flag และหน้า ESC)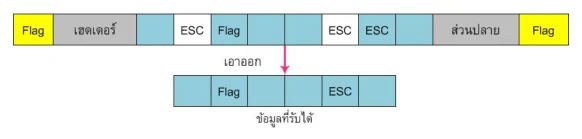
Flag กับ ESC กลับมาเป็นข้อมูลจริง ไม่ใช่ตัวคั่น)| ขั้น | สิ่งที่ได้ (ไล่ตามรูปที่ 10.5 → 10.6) |
|---|---|
| ① ข้อมูลที่ต้องการส่ง | … Flag … ESC … ← มีทั้งไบต์ Flag และไบต์ ESC ปนอยู่ในข้อมูล |
| ② ฝั่งส่งทำ byte stuffing | … ESC Flag … ESC ESC … ← เติม ESC หน้าไบต์ทั้งสอง |
| ③ เฟรมที่วิ่งบนสาย | Flag │ เฮดเดอร์ │ … ESC Flag … ESC ESC … │ ส่วนปลาย │ Flag |
| ④ ฝั่งรับถอด ESC | เจอ ESC → ทิ้ง ESC ตัวนั้น แล้วรับไบต์ถัดไปเป็นข้อมูลตรง ๆ (ไม่ตีความว่าเป็นตัวคั่น) |
| ⑤ ข้อมูลที่ได้รับ | … Flag … ESC … ← ตรงกับต้นฉบับเป๊ะ ✓ |
คนส่วนใหญ่จำแค่ "ESC ก่อน Flag" แล้วลืมกรณี ESC-ESC ถ้าข้อมูลมีไบต์ ESC อยู่แล้วไม่ทำ escape ซ้ำ ฝั่งรับจะกินไบต์ถัดจาก ESC เข้าไปเป็นข้อมูลผิด ๆ ทั้งที่มันเป็นข้อมูลจริง — ทั้ง Flag และ ESC ที่โผล่ในข้อมูลต้องถูก escape ทั้งคู่
กรณีที่ทำไม่ครบแล้ว "พัง" — ไล่ให้ดูสองแบบ
หนังสือเขียนกรณีพังไว้ตรง ๆ ว่า "การกำจัดไบต์ ESC ของภาครับอาจทำงานไม่ถูกต้อง หากไบต์ที่ตามมาจาก ESC ไม่ใช่ Flag" ลองไล่ให้เห็นของจริง โดยใช้ข้อมูล A · Flag · B · ESC · C ชุดเดิม:
| กรณี | เฟรมที่ส่งออกไป | ฝั่งรับอ่านได้เป็น | ผล |
|---|---|---|---|
| พังแบบ 1 ไม่ escape Flag เลย |
Flag │ A Flag B ESC C │ Flag |
A แล้วจบ — เพราะเจอ Flag ตัวที่สองก็ตัดเฟรมทันที |
ได้ข้อมูลแค่ A · ส่วน B ESC C กลายเป็นขยะ/เฟรมใหม่ที่ไม่มีหัว → เฟรมหลุดจังหวะยาว |
| พังแบบ 2 escape Flag แต่ลืม ESC-ESC |
Flag │ A ESC Flag B ESC C │ Flag |
A · Flag · B · (ทิ้ง ESC) · C ในฐานะตัวที่ถูก escape |
ไบต์ ESC จริงหายไปหนึ่งตัว — ข้อมูลสั้นลง 1 ไบต์และเนื้อผิด แต่ไม่มีสัญญาณเตือนใด ๆ เพราะเฟรมยังตัดถูกที่ |
| ทำถูก | Flag │ A ESC Flag B ESC ESC C │ Flag |
A · Flag · B · ESC · C |
ครบถ้วนตรงต้นฉบับ ✓ |
แบบ 1 พังแบบ "เห็นชัด" — เฟรมสั้นผิดปกติ ตัวตรวจสอบข้อผิดพลาดท้ายเฟรม (บทที่ 12) จับได้แน่ แต่แบบ 2 พังเงียบ เฟรมยังหน้าตาปกติ ความยาวเพี้ยนไปแค่ไบต์เดียว และถ้าไบต์ที่ตามหลัง ESC บังเอิญเป็นข้อมูลธรรมดา ฝั่งรับก็จะกลืนเข้าไปโดยไม่รู้ตัว → จำสั้น ๆ ว่า "ESC ต้อง escape ตัวเองด้วยเสมอ"
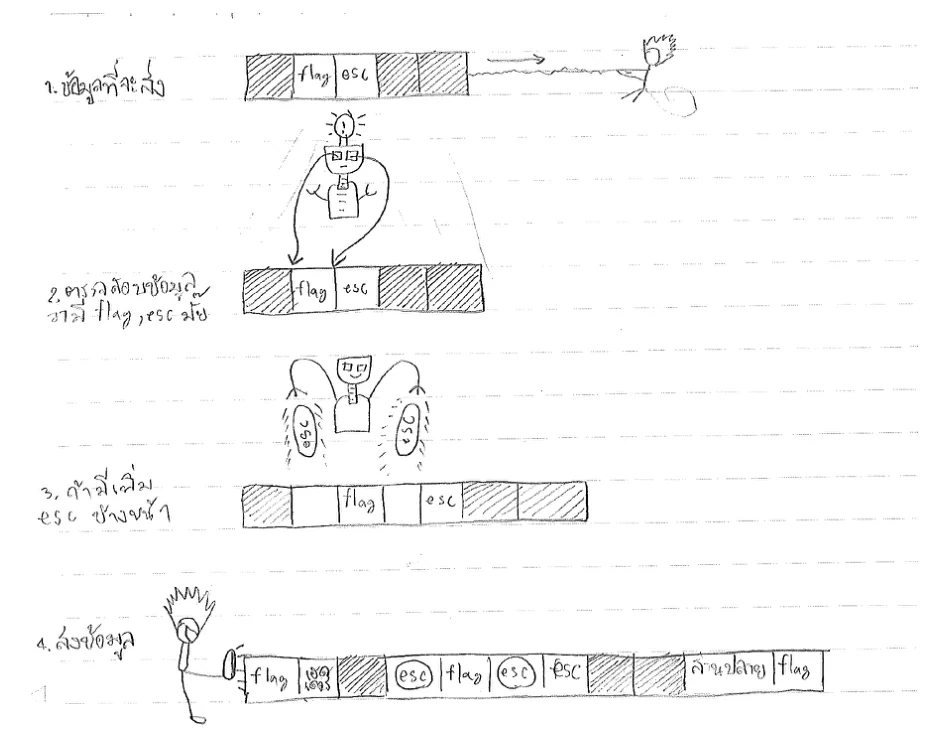
flag หรือ esc ปนอยู่ไหม → ③ ถ้ามี ให้เติม esc ข้างหน้า → ④ ส่งออกไปโดยมี flag หัวและท้าย · เป็นลำดับที่ควรท่องไปใช้ในห้องสอบ)Bit-oriented + Bit Stuffing ออกสอบ Q11 ข้อ b
Bit-oriented ใช้ 01111110 เป็น flag ที่จุดเริ่มต้นและสิ้นสุดของเฟรม สังเกตว่า flag คือ เลข 1 ติดกัน 6 ตัว ขนาบด้วย 0 ทั้งสองข้าง
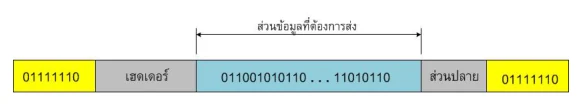
01111110" และวงเล็บด้านบนย้ำอีกครั้งว่า stuffing ทำเฉพาะในส่วนข้อมูล)1 ติดกันครบ 5 ตัว → แทรก 0 ลงไป 1 ตัวทันที
กติกา bit stuffing — แล้วเริ่มนับใหม่จากศูนย์
เหตุผล: เพื่อป้องกันไม่ให้ข้อมูลที่จะส่งกลายเป็น 01111110 ไปชนกับ flag เพราะเมื่อมี 0 ถูกยัดเข้าไปหลังเลข 1 ห้าตัวเสมอ จึงเป็นไปไม่ได้เลยที่จะมี 1 ติดกัน 6 ตัวโผล่ขึ้นในส่วนข้อมูล
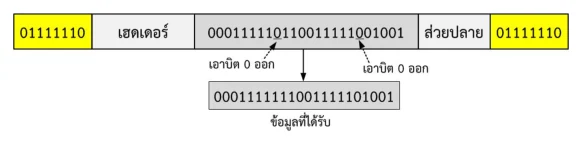
ฝั่งรับทำย้อนกลับ: เมื่อพบว่ามีบิต 1 ติดต่อกัน 5 บิต (ยกเว้นที่จุดเริ่มต้นและสิ้นสุดเฟรม) ภาครับจะนำบิต 0 ที่ตามมาออก เพื่อให้ได้ข้อมูลที่แท้จริง
ตัวอย่างจริงในตำรา — รูปที่ 10.8 (ฝั่งส่ง) และรูปที่ 10.9 (ฝั่งรับ)
ช่องพิมพ์ด้านบนให้เราลองบิตชุดไหนก็ได้ ส่วนข้างล่างนี้คือตัวเลขชุดที่ตำราใช้จริง ให้ไล่มือตามให้ได้ก่อนเข้าห้องสอบ:
0001111111001111101001 (22 บิต)
โจทย์ตัวอย่างของรูปที่ 10.8
| ก้อน | สิ่งที่เกิดขึ้น | ผลลัพธ์สะสม |
|---|---|---|
000 | ไม่มี 1 ติดกัน ปล่อยผ่าน | 000 |
1111111 (1 เจ็ดตัว) | พอครบ 1 ห้าตัว → แทรก 0 ตัวที่ 1 แล้วรีเซ็ตตัวนับ · เหลือ 11 นับใหม่เป็น 2 | 000 111110 11 |
00 | เจอ 0 → ตัวนับกลับเป็นศูนย์ | …11 00 |
11111 (1 ห้าตัว) | ครบ 5 พอดี → แทรก 0 ตัวที่ 2 | …00 111110 |
01001 | ไม่มี 1 ติดกันถึง 5 ปล่อยผ่านหมด | …0 01001 |
| รวมทั้งหมด (22 บิต + แทรก 2 บิต) | 000111110110011111001001 → 24 บิต | |
เขียนติดกันจะได้ 000111110110011111001001 ตรงกับตัวเลขในรูปที่ 10.8 พอดี แล้วประกบด้วย flag หัวท้ายได้เฟรมจริง 01111110 + 000111110110011111001001 + 01111110 รวม 40 บิต
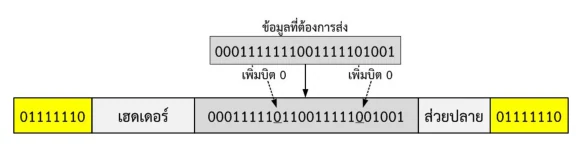
11111 ทั้งสองกลุ่ม)ฝั่งรับทำย้อนกลับ: กวาดไปเจอ 1 ติดกันครบ 5 เมื่อไร ให้ลบบิตถัดไปทิ้ง (ซึ่งเป็น 0 ที่ฝั่งส่งแทรกไว้แน่นอน เพราะถ้ามันเป็น 1 นั่นจะกลายเป็น flag ไปแล้ว) — ได้ 0001111111001111101001 กลับมาครบ 22 บิตเท่าเดิม
- นับใหม่ทุกครั้งที่แทรก — หลังยัด 0 เข้าไปแล้ว ตัวนับ 1 ติดกันต้องรีเซ็ตเป็น 0 ไม่ใช่นับต่อ
- ห้าม stuff ใน flag — flag
01111110ที่หัวและท้ายเฟรมเป็นตัวคั่น ไม่ใช่ข้อมูล จึงไม่โดนแทรก 0 (ถ้าเผลอไปแทรกในนั้น flag จะเสียทันที) - ในหนังสือเขียนว่า "มีจำนวนติดต่อกันมากกว่า 5 บิต" แต่ในย่อหน้าฝั่งรับเขียนว่า "พบ 1 ติดต่อกันจำนวน 5 บิต แล้วนำ 0 ที่ตามมาออก" — ให้ยึดกติกามาตรฐาน คือครบ 5 ตัวเมื่อไรก็แทรก 0 ทันที ซึ่งเป็นวิธีที่ทำให้ฝั่งส่งกับฝั่งรับตรงกันพอดี และเป็นวิธีที่ข้อสอบใช้ตรวจ
ลองมือ: ข้อมูล 0111111011111110 ส่งออกไปเป็นอะไร
ไล่ทีละบิต แล้วเว้นวรรคให้ดูง่าย (ตัวหนา = 0 ที่ถูกแทรกเข้าไป):
0 11111 0 1 0 11111 0 110
รวมเป็น 011111010111110110 — จาก 16 บิต กลายเป็น 18 บิต (แทรกไป 2 ตัว)
เฟรมที่ออกไปบนสายจริงคือ 01111110 + 011111010111110110 + 01111110 รวม 34 บิต — ระวังตอนเขียนคำตอบ: ต้องมี flag หัว-ท้ายเสมอ ถ้าโจทย์ถามว่า "เฟรมที่ส่ง" ไม่ใช่ "ข้อมูลหลัง stuffing" (ลองพิมพ์ตัวเลขชุดนี้ลงในภาพเคลื่อนไหวด้านบนเพื่อตรวจคำตอบได้เลย)
กรณีที่ "ไม่ทำ" bit stuffing แล้วพัง
รูปที่ 10.8 กับ 10.9 เป็นตัวอย่างตอนทุกอย่างเรียบร้อย แต่เหตุผลที่ bit stuffing ต้องมีอยู่ ต้องดูตอนมันพัง ลองสมมุติข้อมูล 16 บิต ที่ดันมี flag ซ่อนอยู่กลางตัว:
1011 01111110 0011
ส่วนตัวหนาบังเอิญเหมือน flag เป๊ะทุกบิต
| เฟรมที่วิ่งบนสาย | ฝั่งรับตัดเฟรมตรงไหน | ผล | |
|---|---|---|---|
| ไม่ stuff | 01111110 │ 1011 01111110 0011 │ 01111110 |
เจอ 01111110 ตัวที่สองกลางข้อมูล → นึกว่าเฟรมจบตรงนั้น |
ส่งขึ้นไปได้แค่ 1011 · ที่เหลือ 0011 + flag ท้าย กลายเป็นเศษเฟรมไร้หัว → ข้อมูลหาย + เฟรมถัดไปหลุดจังหวะตามไปอีก |
| stuff ถูกต้อง | 01111110 │ 1011011111010 0011 │ 01111110 |
ในส่วนข้อมูลไม่มีทางมี 1 ติดกัน 6 ตัวได้อีกเลย → ตัดเฟรมที่ flag ท้ายอย่างเดียว | ถอด 0 ที่แทรกออก ได้ 1011 01111110 0011 ครบ 16 บิต ✓ |
ไล่มือฝั่งส่ง: 1 0 11 0 11111 ← ครบ 5 ตรงนี้จึงแทรก 0 แล้วรีเซ็ต ต่อด้วย 1 0 0 0 11 → ได้ 10110111110100011 (17 บิต) → เฟรมเต็ม 8 + 17 + 8 = 33 บิต
ข้อสอบใช้กติกาชุดเดียวกันเป๊ะ เพียงแต่ตัวเลขมาจากข้อ a (odd parity):
- ข้อมูลเข้า (ผลจาก Q11 ข้อ a ของรหัสลงท้าย 3) =
101111101011013 บิต - เจอ
1ครบ 5 ตัวที่ตำแหน่ง 3–7 → แทรก0ได้1011111001011014 บิต - เฟรมที่ส่งจริง =
01111110│10111110010110│01111110รวม 30 บิต
10.3มัลติเพล็กซิง (Multiplexing)
การทำมัลติเพล็กซ์คือการจัดการในการใช้ทรัพยากรร่วมกัน เพื่อประสิทธิภาพของการใช้สูงสุด ทรัพยากรที่กล่าวถึงคือ แบนด์วิดท์ ซึ่ง
- มีหน่วยเป็น เฮิรตซ์ (Hz) ในการส่งแบบแอนะล็อก
- มีหน่วยเป็น บิตต่อวินาที (bps) ในการส่งแบบดิจิทัล
การทำมัลติเพล็กซ์คือการแบ่งช่องสัญญาณออกเป็นส่วนย่อย ทำได้ใน 3 รูปแบบพื้นฐาน:
| แบบ | แบ่งอะไร | สื่อ | อนาล็อก/ดิจิทัล |
|---|---|---|---|
| FDM (Frequency-Division) | เชิงความถี่ | สายทองแดง / อากาศ | ต้องเป็นแอนะล็อก |
| TDM (Time Division) | เชิงเวลา | อะไรก็ได้ | ต้องเป็นดิจิทัลเท่านั้น |
| WDM (Wavelength-Division) | เชิงความยาวคลื่น | ใยแก้วนำแสงเท่านั้น | เชิงแสง |
10.3.1การมัลติเพล็กซ์แบบแบ่งความถี่ (FDM)
FDM คือการแบ่งช่วงความถี่ทั้งหมดออกเป็นส่วนย่อย เพื่อจัดสรรแต่ละส่วนให้กับผู้ใช้แต่ละคน ขั้นตอน:
- ผู้ใช้แต่ละคน มอดูเลต (modulate) สัญญาณของตัวเองไปยังช่วงความถี่ที่ตนได้รับการจัดสรร
- สัญญาณทั้งหมดถูกมัลติเพล็กซ์เข้าด้วยกัน เพื่อส่งเข้าในช่องสัญญาณไปยังภาครับ
- ภาครับแยกสัญญาณมัลติเพล็กซ์ แล้วส่งข้อมูลไปยังช่องสัญญาณที่เหมาะสม
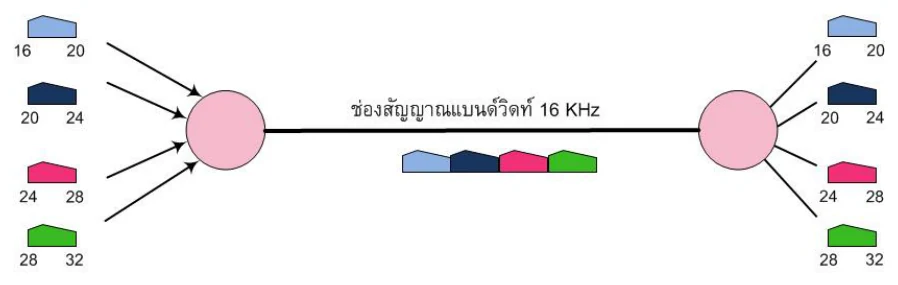
อ่านรูปนี้ให้ได้ประเด็น 3 อย่าง: (1) ทุกคนส่งพร้อมกันตลอดเวลา ไม่มีใครต้องรอคิว (2) สิ่งที่แบ่งกันคือย่านความถี่ ไม่ใช่เวลา (3) ย่าน 16→32 kHz กว้าง 16 kHz พอดี = 4 คน × 4 kHz ซึ่งเป็นที่มาของเลขในกล่องสูตรด้านบน
ในระบบจริงต้องเว้น guard band ระหว่างย่านความถี่ของแต่ละคนเล็กน้อย เพื่อกันสัญญาณรั่วข้ามย่าน (crosstalk) ดังนั้นจำนวนผู้ใช้จริงจะได้น้อยกว่าผลหารตรง ๆ นิดหน่อย — แต่ในการสอบให้คิดตามหนังสือคือหารตรง ๆ
10.3.2การมัลติเพล็กซ์แบบแบ่งเวลา (TDM) ออกสอบ Q2
ทำไม TDM ถึงได้รับความนิยมมากกว่า? หนังสือให้เหตุผลเป็นลูกโซ่:
| แบบ | ข้อจำกัด |
|---|---|
| WDM | รองรับข้อมูลขนาดใหญ่ได้ดี แต่รองรับเฉพาะใยแก้วนำแสง → ตอบสนองผู้ใช้บนสายโทรศัพท์/สายทองแดงไม่ได้ |
| FDM | รองรับสายทองแดงได้ แต่ต้องเป็นระบบแอนะล็อก → ไม่สะดวกต่อการใช้ในระบบคอมพิวเตอร์ |
| TDM | ทำงานได้ด้วยระบบที่เป็นดิจิทัลทั้งระบบ → นิยมมากกว่า แต่ต้องเป็นดิจิทัลเท่านั้น ซึ่งเป็นข้อจำกัดของ TDM |
FDM = แบ่งห้องเรียนออกเป็นห้องเล็ก ๆ หลายห้อง ทุกคนเข้ามาใช้ในห้องของตนเอง (ใช้พร้อมกัน แต่คนละพื้นที่)
TDM = ทุกคนสามารถใช้ห้องเต็มห้องได้ ตามเวลาที่กำหนด (ใช้เต็มพื้นที่ แต่คนละเวลา)
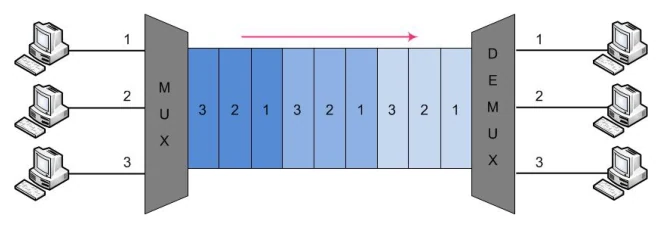
… 3 2 1 3 2 1 3 2 1 — ลำดับตายตัวแบบนี้เองที่ทำให้ฝั่ง DEMUX นับตำแหน่งแล้วรู้ว่าสล็อตไหนของใคร)เทียบกับรูปที่ 10.10 (FDM) จะเห็นความต่างทันที: ใน FDM ทั้ง 4 ก้อนสีอยู่บนสายพร้อมกันคนละย่านความถี่ แต่ใน TDM สล็อตของ 1, 2, 3 ผลัดกันครองสายทั้งเส้นทีละคน — ช่องสัญญาณเดียวกัน แต่คนละแกน (แกนความถี่ ↔ แกนเวลา)
สล็อตและเฟรม
ข้อมูลของแต่ละช่องสัญญาณจะถูกแบ่งออกเป็น สล็อต (slot) โดยแต่ละสล็อตอาจเป็น
- หนึ่งบิต ← แบบที่ข้อสอบใช้
- หนึ่งตัวอักษร
- หนึ่งบล็อก (block) ของข้อมูล
จากนั้นข้อมูลจะถูกมัลติเพล็กซ์รวมกันเป็นเฟรม สมมุติให้มีขาเข้า n ช่อง แต่ละเฟรมจะประกอบด้วย n สล็อต โดยแต่ละสล็อตถูกกำหนดให้กับแต่ละช่อง
ภาพเคลื่อนไหวด้านบนมองจากมุมของเฟรมที่ประกอบเสร็จแล้ว ส่วนรูปข้างล่างของตำรามองจากมุมของเวลา ว่าข้อมูลขาเข้าที่ยืดยาว ถูกบีบให้สั้นลงตอนขาออกอย่างไร
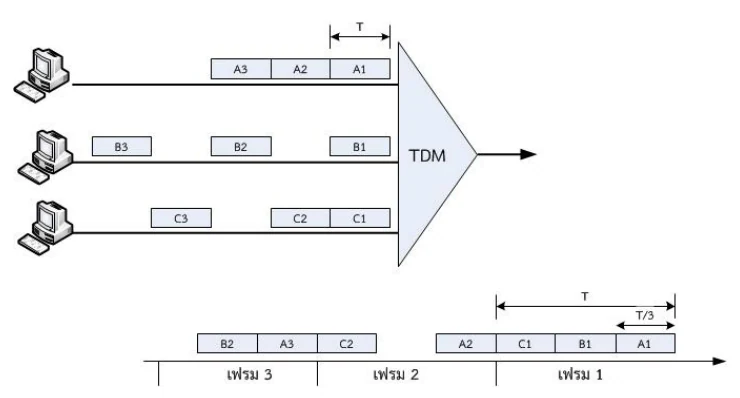
| เฟรม | สล็อต A | สล็อต B | สล็อต C | สังเกต |
|---|---|---|---|---|
| เฟรม 1 | A1 | B1 | C1 | ทุกแหล่งมีข้อมูล → เฟรมเต็ม |
| เฟรม 2 | A2 | — ว่าง — | C2 | B ไม่มีข้อมูลรอบนี้ แต่สล็อตยังถูกจองไว้ว่าง ๆ |
| เฟรม 3 | A3 | B2 | — ว่าง — | คราวนี้ C ไม่มีข้อมูล ก็ยังจองอีก |
หลายคนดูรูปนี้แล้วนึกว่าเฟรม 2 กับ 3 สั้นกว่า เฟรม 1 — ไม่ใช่ ทุกเฟรมกว้าง T เท่ากันเป๊ะ ช่องที่เว้นไว้คือสล็อตที่จองแล้วแต่ไม่มีใครใช้ เวลานั้นเสียไปฟรี ๆ บนสาย · ลองนับจากรูป: 9 สล็อตถูกจอง แต่มีข้อมูลจริง 7 ก้อน → ใช้สายได้ 7/9 ≈ 78% · นี่คือปัญหาที่ Statistical TDM (หัวข้อถัดไป) เกิดมาเพื่อแก้พอดี
เฟรมบิต (Framing bit / Sync bit)
TDM ไม่ง่ายเหมือน FDM เพราะภาคส่งและภาครับต้องซิงโครไนซ์กันอย่างถูกต้อง ถ้าซิงโครไนเซชันผิดพลาด ภาครับอาจได้รับข้อมูลจากช่องข้อมูลอื่น (เช่น เอาสล็อตของ B ไปให้ปลายทางของ A)
วิธีแก้: แต่ละเฟรมจะเพิ่มบิตเข้าไป 1 บิต เรียกว่า "เฟรมบิต" ทำให้ภาครับแยกข้อมูลที่เข้ามาได้ถูกต้อง โดยเฟรมบิตนี้จะสลับระหว่างบิต 0 และบิต 1 เสมือนเป็นลำดับของเฟรม
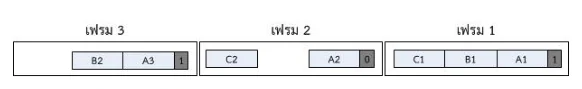
1 → 0 → 1 · เนื้อในสามเฟรมเป็นชุดเดียวกับรูปที่ 10.12 เป๊ะ แค่เพิ่มเฟรมบิตเข้ามา)ถ้าไม่มีเฟรมบิตแล้วพังยังไง — ตัวอย่างตอนซิงโครไนเซชันหลุด
หนังสือเขียนกรณีพังไว้ว่า "ความผิดพลาดของการทำซิงโครไนเซชัน อาจทำให้ภาครับได้รับข้อมูลจากช่องข้อมูลอื่นได้" — ลองใช้ข้อมูลชุดเดียวกับรูปที่ 10.12 แล้วสมมุติว่า สัญญาณรบกวนกลืนสล็อตแรกไป 1 สล็อต:
| ตำแหน่งสล็อตที่ภาครับนับได้ | 1 | 2 | 3 | 4 | 5 | 6 | ภาครับส่งขึ้นไปให้ใคร |
|---|---|---|---|---|---|---|---|
| ควรจะเป็น | A1 | B1 | C1 | A2 | — | C2 | A ได้ A1, B ได้ B1, C ได้ C1 ✓ |
| เมื่อ A1 หายไป 1 สล็อต | B1 | C1 | A2 | — | C2 | A3 | A ได้ B1 · B ได้ C1 · C ได้ A2 ✗ — ทุกคนได้ข้อมูลของคนอื่นหมด และผิดต่อเนื่องไปทุกเฟรมหลังจากนั้น |
สังเกตว่าความเสียหายไม่ได้จบที่สล็อตเดียว — มันเลื่อนทั้งสายไปตลอดกาล เพราะ Synchronous TDM ให้ภาครับ "นับตำแหน่ง" เอาอย่างเดียว ไม่มีป้ายชื่อกำกับในสล็อต (ต่างจาก Statistical TDM ที่มีแอดเดรส)
เฟรมบิตแก้ปัญหานี้ด้วยการเป็นหลักไมล์ที่คาดเดาได้: ภาครับรู้ว่าเมื่อครบ 1 เฟรม (ในรูปที่ 10.13 คือ 1 เฟรมบิต + 3 สล็อต) จะต้องเจอเฟรมบิตตัวถัดไปที่สลับค่าเป็น 1, 0, 1, 0, … ถ้าจู่ ๆ ลำดับที่คาดไว้ไม่ตรง แปลว่าหลุดจังหวะแล้ว ภาครับจึงรู้ตัวและไปไล่หาขอบเฟรมใหม่ (resynchronize) แทนที่จะส่งข้อมูลผิดคนไปเรื่อย ๆ
เฟรมบิตไม่ใช่บิตตรวจสอบข้อผิดพลาด (parity/CRC) และไม่ได้ซ่อมข้อมูลที่หายให้ — มันแค่บอกว่า "ขอบเฟรมอยู่ตรงนี้" เท่านั้น · และมันคือบิตเดียวกันกับ sync bit ที่ทำให้ขนาดเฟรมในข้อสอบ Q2 กลายเป็น 21 บิตแทนที่จะเป็น 20 และทำให้ T-1 เป็น 193 บิตแทนที่จะเป็น 192
สูตรคำนวณ TDM (ต้องจำให้ได้)
| สัญลักษณ์ | ความหมาย | ได้มาจากไหน |
|---|---|---|
n | จำนวนแหล่งข้อมูล / ช่องสัญญาณขาเข้า | โจทย์บอก |
R | อัตราของแต่ละแหล่ง (bps) | โจทย์บอก เช่น 100 kbps |
b | จำนวนบิตต่อหนึ่งสล็อต | โจทย์บอก (1 บิต / 1 อักขระ = 8 บิต / 1 บล็อก) |
f | จำนวนเฟรมบิต (sync bit) ต่อเฟรม | ปกติ = 1 |
| อัตราเฟรม | จำนวนเฟรมต่อวินาที = R / b | คำนวณ |
T | เวลาต่อเฟรม = b / R | คำนวณ |
แทนค่าจริง ① — โจทย์ข้อสอบเก่า (Q2)
โจทย์: มีแหล่งข้อมูล 20 แหล่ง แต่ละแหล่งส่งที่ 100 kbps นำมาทำ TDM โดยแต่ละสล็อตเก็บข้อมูล 1 บิตต่อหนึ่งแหล่ง และแต่ละเฟรมมี sync bit เพิ่มอีก 1 บิต จงหา (a) ความเร็วของการส่งข้อมูล 1 บิต (b) ขนาดเฟรม output (พร้อมวาดรูป) (c) ความเร็วของการส่งข้อมูล (Link Data Rate)
ถอดตัวแปรก่อน: n = 20, R = 100 kbps = 100,000 bps, b = 1, f = 1
| ข้อ | วิธีคิด | คำตอบ |
|---|---|---|
| (a) ความเร็วของการส่งข้อมูล 1 บิต | คำว่า "ของการส่งข้อมูล 1 บิต" คือถามเวลา ⇒ ต้องกลับเศษส่วนของอัตราTbit = 1 / R = 1 / (1×10⁵) = 1×10⁻⁵ sเขียนกำกับต่อท้ายได้ว่า "(อัตราของแต่ละแหล่งยังคง 100 kbps เท่าเดิม เพราะ TDM ไม่ได้ทำให้ใครส่งเร็วขึ้น)" |
10 µs |
| (b) ขนาดเฟรม | (n × b) + f = (20 × 1) + 1 | 21 บิต |
| (c) ความเร็วของการส่งข้อมูล (อัตราของลิงก์) | Link Data Rate = Frame Rate × Frame Size= 100,000 เฟรม/วินาที × 21 บิต = 2,100,000 bpsเฉพาะบิตข้อมูลของผู้ใช้ n × R = 2 Mbps ซึ่งเป็นคำตอบของคำถามคนละข้อ |
2.1 Mbps |
รูปที่ต้องวาดในข้อ (b) — โจทย์สั่งให้วาดเฟรมด้วย อย่าลืม
เฉลยฉบับใหม่ให้วาดเฟรมออกมาแบบนี้ (เรียง sync bit ไว้หัวเฟรมเหมือนรูปที่ 10.13 ในหนังสือ):
| Sync | Slot 1 | Slot 2 | Slot 3 | ⋯ | Slot 19 | Slot 20 | รวม |
|---|---|---|---|---|---|---|---|
| 1 บิต | 1 บิต | 1 บิต | 1 บิต | ⋯ | 1 บิต | 1 บิต | 21 บิต = 1 เฟรม |
| เฟรมบิต (สลับ 0/1) |
แหล่ง 1 | แหล่ง 2 | แหล่ง 3 | ⋯ | แหล่ง 19 | แหล่ง 20 | ใช้เวลา T = 10 µs |
ตารางนี้แทนรูปในเฉลย [Sync 1b][Slot1 1b][Slot2 1b] … [Slot20 1b] — เขียนลงกระดาษสอบเป็นกล่องเรียงกันแบบนี้ได้เลย จุดที่กรรมการดูคือ มีกล่อง sync อยู่ด้วย และนับกล่องข้อมูลได้ 20 กล่อง
- ข้อ (a) ต้องตอบเป็น "เวลา" ไม่ใช่ "อัตรา" — เฉลยเก่าตอบ
100 kbpsซึ่งเป็นการลอกตัวเลขจากโจทย์ ไม่ได้คำนวณอะไรเลย · ที่ถูกคือTbit = 1/R = 10 µs - ข้อ (c) ต้องนับ sync bit ด้วย — เฉลยเก่าตอบ 2 Mbps ซึ่งผิด เพราะตัด sync bit ออกจากสมการทั้งที่โจทย์กำหนดมาให้เอง · sync bit ไม่ใช่บิตในจินตนาการ มันกินเวลาบนสายเท่ากับบิตข้อมูลทุกประการ ⇒ ลิงก์ต้องวิ่ง 2.1 Mbps
- 2 Mbps ไม่ใช่ 2000 Mbps — หน่วยของ R คือ kbps ไม่ใช่ Mbps · 20 × 100 kbps = 2,000 kbps = 2 Mbps · วิธีกันพลาด: เขียน
100 kbps = 100,000 bpsตั้งแต่บรรทัดถอดตัวแปร แล้วคำนวณด้วยเลขเต็มตลอด - sync bit ทำให้เฟรมอ้วนขึ้น ไม่ได้ทำให้เฟรมถี่ขึ้น — อัตราเฟรมยังเป็น 100,000 เฟรม/วินาทีเท่าเดิม ที่โตคือขนาดเฟรม 20 → 21 บิต
เช็กตัวเลขให้แน่น: b = 1 แปลว่าแต่ละเฟรมพาข้อมูลของแต่ละแหล่งไปแค่ 1 บิต ดังนั้นแหล่งที่ส่ง 100,000 บิต/วินาที ต้องการ 100,000 เฟรม/วินาที → เวลาต่อเฟรม T = 1/100,000 = 10 µs และเวลาต่อสล็อตข้อมูล = T/n = 10/20 = 0.5 µs
แทนค่าจริง ② — สาย T-1 (ตัวอย่างจากหนังสือ)
แม้ TDM จะเป็นระบบดิจิทัล แต่ก็รองรับข้อมูลแอนะล็อกได้ เช่นระบบโทรศัพท์ โดยผ่านอุปกรณ์แปลงจากแอนะล็อกเป็นดิจิทัลก่อน แล้วค่อยทำ TDM ต่อ ตัวอย่างคือระบบ T lines ที่ออกแบบมาเพื่อสื่อสารข้อมูลดิจิทัล เสียง และภาพเคลื่อนไหว (video)
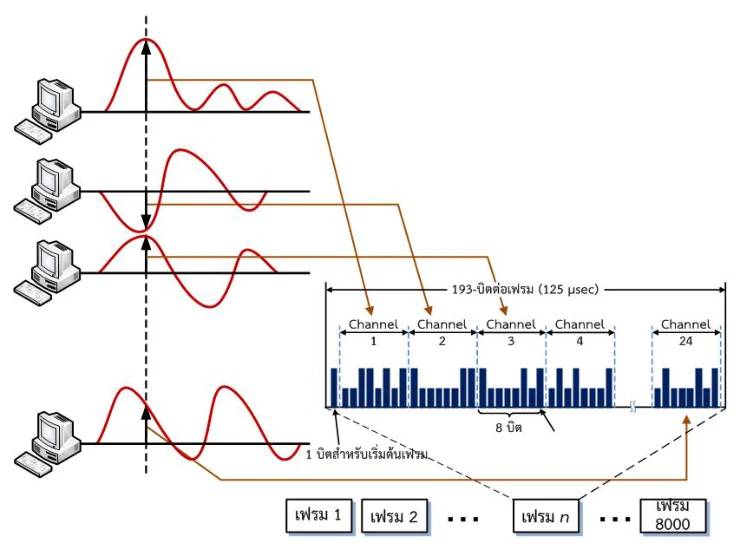
| ตัวแปร | ค่า |
|---|---|
n จำนวนช่องสัญญาณ | 24 |
b บิตต่อสล็อต | 8 (จากรูป — "8 บิต" ต่อ Channel) |
f เฟรมบิต | 1 (1 บิตสำหรับเริ่มต้นเฟรม) |
| ขนาดเฟรม | (24 × 8) + 1 = 192 + 1 = 193 บิต |
| อัตราเฟรม | 8000 เฟรม/วินาที (= 125 µs ต่อเฟรม) |
| Data rate ของ T-1 | 193 × 8000 = 1.544 Mbps |
เช็กย้อน: แต่ละช่องเสียงได้ 8 บิต × 8000 ครั้ง/วินาที = 64 kbps ซึ่งตรงกับอัตรามาตรฐานของช่องเสียงดิจิทัลหนึ่งช่อง และ 24 × 64 kbps = 1.536 Mbps + เฟรมบิต 8 kbps = 1.544 Mbps พอดี
Synchronous TDM vs Statistical TDM
TDM แบบที่เราศึกษามาทั้งหมดข้างบนเรียกอีกอย่างว่า Synchronous TDM โดยแต่ละช่องสัญญาณถูกกำหนดสล็อตที่แน่นอน ผลคือ:
หากมีช่องใดช่องหนึ่งไม่มีการส่งข้อมูล สล็อตของช่องนั้นก็ยังถูกจองไว้แต่ว่างเปล่า → ใช้แบนด์วิดท์อย่างไม่มีประสิทธิภาพ
วิธีแก้คือ Statistical TDM:
- กำหนดสล็อตให้แต่ละช่องก็ต่อเมื่อมีข้อมูลที่จะส่งเท่านั้น
- จำนวนสล็อตจะมีน้อยกว่าจำนวนช่องสัญญาณขาเข้า
- แต่ละช่องสัญญาณถูกตรวจสอบว่ามีข้อมูลจะส่งหรือไม่แบบ Round-robin — ถ้ามีก็ได้สล็อต ถ้าไม่มีก็ถูกข้ามไป
- เนื่องจากไม่มีการกำหนดช่องสัญญาณไว้ล่วงหน้า แต่ละสล็อตจึงจำเป็นต้องมีแอดเดรสของข้อมูล (A, B, C หรือ D) ที่เฮดเดอร์ ก่อนถูกมัลติเพล็กซ์เป็นเฟรม
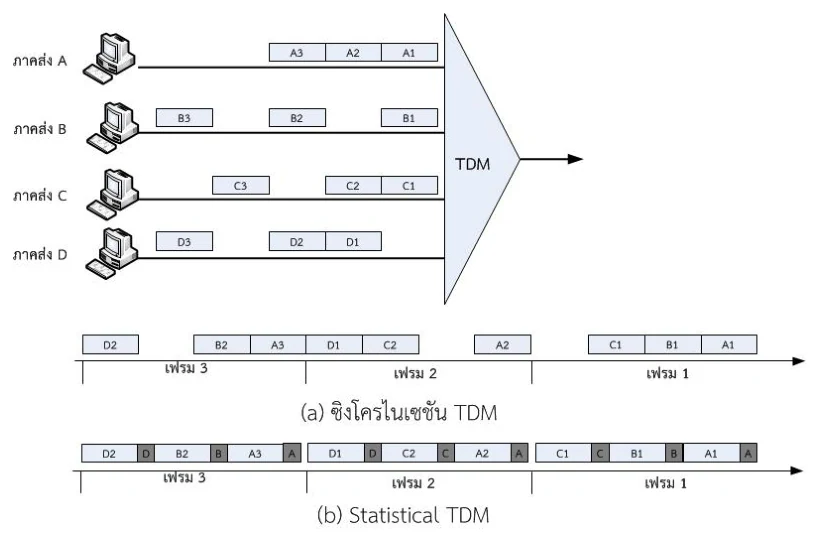
Statistical TDM ไม่ได้ "ฟรี" — สิ่งที่ประหยัดได้จากการไม่จองสล็อตว่าง ต้องแลกกับแอดเดรสที่ต้องแนบไปทุกสล็อต ถ้าทุกแหล่งมีข้อมูลส่งตลอดเวลา Statistical TDM จะแย่กว่า Synchronous TDM เพราะเสียบิตแอดเดรสเปล่า ๆ — มันคุ้มเฉพาะตอนที่ทราฟฟิกเป็นแบบ bursty (มาเป็นช่วง ๆ)
10.3.3การมัลติเพล็กซ์แบบแบ่งความยาวคลื่น (WDM)
นอกจากการมัลติเพล็กซ์เชิงความถี่แล้ว การสื่อสารเชิงแสง (Optical Communication) จะอ้างอิงถึงการใช้ ความยาวคลื่น (wavelength) ที่แตกต่างกันเพื่อใช้ในการส่งข้อมูล
- โดยทั่วไปการสื่อสารเชิงแสงเป็นการเชื่อมแบบจุดต่อจุด โดยอาศัยเส้นใยแก้วนำแสง
- ปัจจุบันการกำเนิดสัญญาณทำด้วย เลเซอร์ไดโอด ทำให้ส่งได้ด้วยสเปกตรัมความถี่ที่แคบลง (narrow frequency spectrum)
- ดังนั้นหากใช้ต้นกำเนิดสัญญาณที่มีความยาวคลื่นแตกต่างกัน จะสามารถส่งสัญญาณแสงไปพร้อมกันภายในช่องสัญญาณเดียวได้ — นี่คือหลักการของ WDM
- หากความยาวคลื่นใกล้ระดับ 1 nm หรือน้อยกว่า เราจะเรียกว่า dense WDM (หนังสือไม่ได้ลงรายละเอียดต่อ)
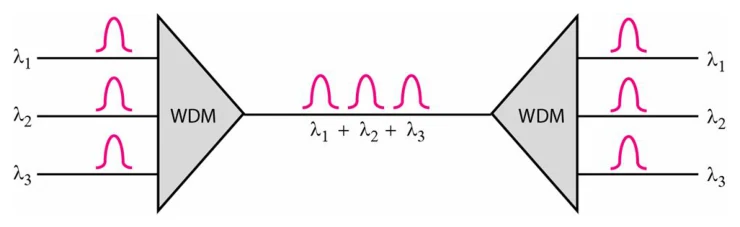
WDM ก็คือ FDM ในโลกของแสง — แนวคิดเดียวกันเป๊ะ (ทุกคนส่งพร้อมกัน แต่คนละย่าน) ต่างกันแค่ว่า FDM แบ่ง "ความถี่" บนสายทองแดง ส่วน WDM แบ่ง "ความยาวคลื่น" บนใยแก้ว ซึ่งความถี่กับความยาวคลื่นก็คือของสิ่งเดียวกันที่มองคนละมุม
10.4Statistic มัลติเพล็กซิง
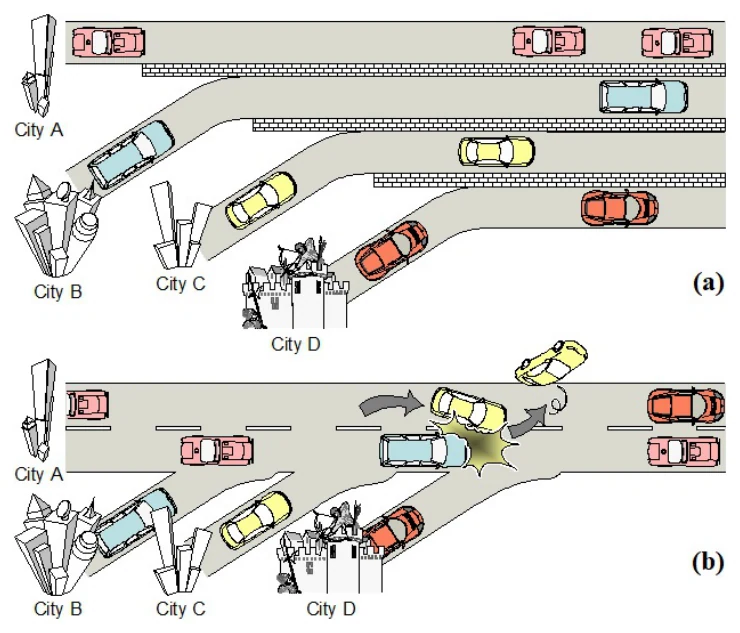
หนังสืออธิบายหัวข้อนี้ด้วยอุปมาการจราจรบนถนนหลายเลน (รูปที่ 10.17) ซึ่งเป็นวิธีที่เข้าใจง่ายที่สุด
TDM และ FDM เป็นตัวอย่างของวิธีการแบ่งลิงก์ให้หลายสายข้อมูลใช้ร่วมกัน โดยมีกฎที่ตายตัว (rigid rules) ในการซอยความจุของลิงก์ กฎที่ตายตัวนี้รับประกันว่าข้อมูลจะถูกส่งอย่างเป็นระเบียบและคาดเดาได้ แต่ก็ทำให้เกิดความไม่มีประสิทธิภาพได้เช่นกัน
รูปบน (a) — ห้ามเปลี่ยนเลน = TDM / FDM
ข้อดี: ไม่มีดีเลย์จากการรวมช่องจราจร (merging) และไม่มีผลลัพธ์ที่คาดเดาไม่ได้จากการสลับเลน
ข้อเสีย: บางเลนว่างเปล่าและไม่ถูกใช้ ในขณะที่เลนอื่นเต็มจนรถเข้าไม่ได้ → การห้ามข้ามเลนทำให้เวลาเดินทางเพิ่มขึ้น เพราะบางเลนไม่ถูกใช้ ในขณะที่เลนอื่นแน่นชั่วขณะ
รูปล่าง (b) — เปลี่ยนเลนได้ = Statistical Multiplexing
ข้อดี: โดยรวมแล้วถนนถูกใช้อย่างมีประสิทธิภาพมากกว่า
ข้อเสีย: เกิดดีเลย์ที่จุดรวมช่องจราจร (merging points) และอาจเกิดการชนกัน (collisions) — สถานการณ์นี้คือ statistical multiplexing ที่ใช้ packet multiplexer
ทำไมระบบจริงถึงออกแบบให้ความจุ "ไม่พอ" ตอนพีก
หนังสือสรุปปิดท้ายว่า ระบบในโลกจริงถูกออกแบบด้วยความจุต่ำกว่าจุดพีก (sub-peak capacity) ด้วยเหตุผลทางเศรษฐศาสตร์ ผลก็คือระบบจะเจอความคับคั่งและดีเลย์ในช่วงที่มีการใช้งานสูงสุด
- ถนนหลวงรถติดในชั่วโมงเร่งด่วน
- ร้านอาหารหรือโรงหนังคนแน่นในเย็นวันหยุดสุดสัปดาห์
การออกแบบระบบเหล่านี้ให้รองรับการใช้งานระดับพีกโดยไม่มีดีเลย์เลย จะไม่คุ้มค่าทางเศรษฐกิจ — เพราะโดยส่วนใหญ่ของเวลา ระบบจะถูกใช้งานต่ำกว่าความสามารถ (underutilized)
แนวคิด "แบ่งกันใช้ช่องสัญญาณ" นี้จะกลับมาอีกในบทที่ 13 ในชื่อ FDMA / TDMA (การเข้าถึงช่องสัญญาณแบบแบ่งความถี่/แบ่งเวลา) และ ALOHA / CSMA ซึ่งเป็น statistical multiplexing เวอร์ชันไร้สายที่ "รถชนกัน" ได้จริง ๆ
10.5สรุปและแบบทดสอบ
| ปัญหา | ทางแก้ | รายละเอียดสำคัญ |
|---|---|---|
| ผู้รับไม่รู้ว่าอักขระเริ่มตรงไหน | Asynchronous | start bit + 5–8 data bits + parity + stop bit ต่อทุกอักขระ |
| ผู้รับไม่รู้ว่าเฟรมเริ่ม/จบตรงไหน | Synchronous + flag | flag 8 บิต (1 ไบต์) หัวและท้ายเฟรม |
| ข้อมูลบังเอิญเหมือน flag (ระดับไบต์) | Byte stuffing | แทรก ESC ก่อน Flag และก่อน ESC |
| ข้อมูลบังเอิญเหมือน flag (ระดับบิต) | Bit stuffing | เจอ 1 ครบ 5 ตัว → แทรก 0 |
| นาฬิกาสองฝั่งไม่ตรงกันในระยะไกล | Embed the clocking | แมนเชสเตอร์ (ดิจิทัล) / เฟสคลื่นพาห์ (อนาล็อก) |
| หลายคนต้องใช้สายเส้นเดียว | FDM / TDM / WDM | คนละความถี่ / คนละเวลา / คนละความยาวคลื่น |
| ผู้รับ TDM หลุดจังหวะสล็อต | เฟรมบิต (sync bit) | 1 บิตต่อเฟรม สลับ 0/1 เป็นลำดับเฟรม |
| สล็อตว่างเปล่าเสียแบนด์วิดท์ | Statistical TDM | Round-robin + ต้องมีแอดเดรสทุกสล็อต |
01111110 เมื่อผ่าน bit stuffing แล้ว ส่วนข้อมูลจะกลายเป็นอะไร?0 → 1(นับ 1) → 1(2) → 1(3) → 1(4) → 1(ครบ 5 → แทรก 0 ทันที แล้วรีเซ็ตตัวนับ) → 1(นับ 1 ใหม่) → 0 ได้ผลลัพธ์ 011111010 = 9 บิต · ข้อนี้คือเหตุผลทั้งหมดที่ bit stuffing มีอยู่ — ข้อมูลชุดนี้บังเอิญเหมือน flag เป๊ะ ถ้าไม่ stuff ฝั่งรับจะตัดเฟรมผิดที่- สูตร TDM 3 บรรทัด — ขนาดเฟรม = n·b + f · อัตราข้อมูล = n·R · อัตราลิงก์ = ขนาดเฟรม × (R/b) — เขียนลงกระดาษทดก่อนเริ่มทำเลย
- อ่านโจทย์ให้ออกว่าถาม "ข้อมูล" หรือ "ลิงก์" — 20 × 100 kbps: ข้อมูล = 2 Mbps, ลิงก์ = 2.1 Mbps (คำตอบของ Q2 ข้อ c) · และ 2 Mbps ไม่ใช่ 2000 Mbps · ส่วนข้อ a ที่ถาม "ความเร็วของการส่งข้อมูล 1 บิต" ตอบเป็นเวลา = 10 µs
- T-1 = 24 ช่อง × 8 บิต + 1 = 193 บิต × 8000 เฟรม/วิ = 1.544 Mbps — เลขชุดนี้ถูกถามซ้ำได้ตรง ๆ
- Bit stuffing: flag =
01111110· เจอ1ครบ 5 ตัวแทรก0แล้วรีเซ็ตตัวนับ · อย่าลืมเขียน flag หัว-ท้ายถ้าโจทย์ถาม "เฟรมที่ส่ง" - Byte stuffing: ESC ก่อน Flag และ ESC ก่อน ESC — ฝั่งรับเจอ ESC ก็ทิ้ง ESC แล้วรับตัวถัดไปเป็นข้อมูล
- จำสามคำนี้ให้ไม่สลับกัน: FDM = คนละความถี่ (แอนะล็อก, สายทองแดง) · TDM = คนละเวลา (ดิจิทัลเท่านั้น) · WDM = คนละความยาวคลื่น (ใยแก้วเท่านั้น)
- Async เสียโอเวอร์เฮดต่ออักขระ, Sync เสียโอเวอร์เฮดต่อเฟรม — นี่คือคำตอบของคำถาม "ทำไม sync ถึงมีประสิทธิภาพดีกว่า"