ลักษณะของความผิดพลาดของการสื่อสาร
ช่องสัญญาณทำให้บิตเพี้ยนได้เสมอ — บทนี้คือ 4 วิธีที่ใช้ "จับ" ความเพี้ยนนั้น เรียงจากง่ายที่สุด (พาริตี 1 บิต) ไปจนถึงวิธีที่ใช้จริงในอีเทอร์เน็ตทุกเฟรม (CRC)
ข้อสอบ Q11 มาจากบทนี้ตรง ๆ ทั้งข้อ (15 นาที) แบ่งเป็น 3 ข้อย่อย:
- (a) 2 คะแนน — ใช้ odd parity กับข้อมูล
101111101+ รหัสหลังขีดของนักศึกษา 3 บิต - (b) 2 คะแนน — ใส่ flag
01111110หัวท้าย พร้อมทำ bit stuffing (ทบทวนที่ บทที่ 10) - (c) 6 คะแนน — CRC generator
x³+1กับข้อมูล10110011จงแสดงข้อมูลที่ถูกส่งในช่องสัญญาณ
เฉลยเต็ม ๆ พร้อมการหารทีละบรรทัดอยู่ที่ ข้อสอบ Q11 →
12.0ความผิดพลาดมี 2 แบบ
จาก บทที่ 7.7 เราได้เห็นแล้วว่ามีปัจจัยหลายอย่างที่ทำให้สัญญาณผิดพลาดได้ จึงจำเป็นต้องมีวิธีตรวจสอบและยืนยันความถูกต้องของข้อมูลที่รับได้ หากพิจารณาความผิดพลาดที่เกิดขึ้น แบ่งได้เป็นสองแบบ
1. ความผิดพลาดแบบหนึ่งบิต (Bit Error Rate, BER)
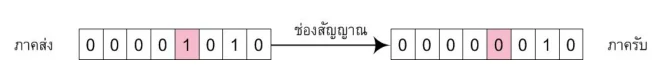
เช่น ภาคส่งส่งลอจิก 1 ออกไป แต่ภาครับได้รับเป็นลอจิก 0 — ผิดแค่บิตเดียว (รูปที่ 12.1)
2. ความผิดพลาดแบบเบิร์สต์ (Burst Error)
คือการที่มีความผิดพลาดของข้อมูลตั้งแต่ 2 บิตติดกันขึ้นไป (รูปที่ 12.2)
ตำราวาดกรณี 1 บิตไว้แบบตรงไปตรงมา — ภาคส่งยิง 0 0 0 0 1 0 1 0 ออกไป แต่ภาครับได้เป็น 0 0 0 0 0 0 1 0 คือบิตที่ 5 พลิกจาก 1 เป็น 0 ที่เหลือครบถ้วนทุกบิต
BER คำนวณยังไง
BER ถูกคำนวณในรูปของค่าความน่าจะเป็น ให้ p คือความน่าจะเป็นของความผิดพลาดของบิตในช่วงเวลาหนึ่ง เช่น BER = 10−3 หมายถึงโดยเฉลี่ยจะมีหนึ่งบิตผิดพลาดในทุก ๆ 1000 บิตที่ส่ง
| สัญลักษณ์ | ความหมาย | หน่วย |
|---|---|---|
Br | จำนวนบิตที่เกิดความผิดพลาด | บิต |
R | ความเร็วของช่องสัญญาณ | บิตต่อวินาที (bps) |
Tm | ช่วงเวลาที่ตรวจจับ | วินาที |
ลองแทนค่า: ถ้าวัดช่องสัญญาณ R = 10 Mbps เป็นเวลา Tm = 2 วินาที แล้วนับได้ว่ามีบิตผิด Br = 20 บิต จะได้
ทำไมในทางปฏิบัติเจอแบบเบิร์สต์มากกว่า
เนื่องจากปัจจุบันความเร็วในการส่งข้อมูลสูงมากในระดับ Mbps หรือ Gbps สมมุติให้ส่งข้อมูลที่ความเร็ว 10 Mbps หากเกิดสัญญาณรบกวนนาน 1 มิลลิวินาที อาจทำให้บิตข้อมูลผิดพลาดถึง 10,000 บิต
ดังนั้นการเกิดสัญญาณรบกวนมีโอกาสเกิดความผิดพลาดเป็นกลุ่มมากกว่าการเกิดแบบหนึ่งบิต แต่ไม่จำเป็นที่จะทำให้ทุกบิตในช่วงนั้นมีค่าผิดไป — ช่วงของความผิดพลาดนี้นับจากบิตแรกที่ผิดไปยังบิตสุดท้ายที่ผิด จะเห็นว่าไม่ใช่ทุกบิตจะมีค่าที่เปลี่ยนไป
รูปที่ 12.2 ในตำราคือตัวอย่างที่ชี้ประเด็นนี้ได้ดีที่สุด — ข้อมูล 16 บิต ส่งไป 0101010001000011 ได้กลับมาเป็น 0100100101100011 ลองเทียบทีละช่อง:
| ตำแหน่งบิต | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ภาคส่ง | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 1 |
| ภาครับ | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 1 | 1 | 0 | 0 | 0 | 1 | 1 |
| เพี้ยนไหม | – | – | – | ✘ | ✘ | ✘ | – | ✘ | – | – | ✘ | – | – | – | – | – |
บิตแรกที่ผิดคือบิตที่ 4 บิตสุดท้ายที่ผิดคือบิตที่ 11 ดังนั้นเบิร์สต์นี้ยาว 8 บิต ทั้ง ๆ ที่จริง ๆ มีบิตเพี้ยนแค่ 5 บิต (บิต 7, 9, 10 ที่อยู่กลางเบิร์สต์ยังถูกต้องอยู่) — นี่คือความหมายของประโยคในตำราที่ว่า "ช่วงของความผิดพลาดนี้นับจากบิตแรกไปยังบิตสุดท้าย จะเห็นว่าไม่ใช่ทุกบิตจะมีค่าที่เปลี่ยนไป"
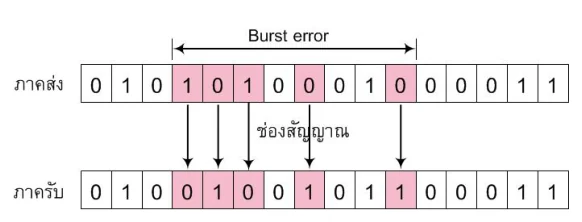
"ความยาวเบิร์สต์" ไม่ใช่ "จำนวนบิตที่ผิด" — ถ้าบิตที่ 5 กับบิตที่ 9 ผิด แต่บิตที่ 6, 7, 8 ยังถูกต้อง เราก็ยังเรียกว่าเบิร์สต์ยาว 5 บิต (นับตั้งแต่บิตแรกที่ผิดถึงบิตสุดท้ายที่ผิด) ไม่ใช่ 2 บิต ตรงนี้สำคัญมากตอนอ่านคุณสมบัติของ CRC ที่บอกว่า "ตรวจจับเบิร์สต์ที่สั้นกว่า R บิตได้ทุกกรณี"
12.1การตรวจจับและแก้ไขความผิดพลาด
การตรวจจับความผิดพลาดถือเป็นขั้นตอนสำคัญในการยืนยันความถูกต้องของข้อมูลที่ได้รับ โดยแบ่งหน้าที่กันดังนี้
- ภาคส่ง — นำข้อมูลที่มาจากแอพพลิเคชัน เข้ารหัสตามรูปแบบหรือเงื่อนไขที่กำหนดในแต่ละโพรโตคอล ก่อนที่จะส่งเข้าไปยังช่องสัญญาณ
- ภาครับ — เมื่อได้รับข้อมูลจากช่องสัญญาณ จะตรวจสอบว่ารูปแบบที่รับได้ถูกต้องหรือไม่ หากไม่เป็นไปตามที่คาดไว้ จะแจ้งให้ภาคส่งทราบว่ามีความผิดพลาดเกิดขึ้นภายในช่องสัญญาณ และกำจัดข้อมูลที่ได้รับทิ้ง
การตรวจสอบข้อผิดพลาดแบ่งได้ 2 แบบ
| Forward Error Control (FEC) | Feedback (backward) error control | |
|---|---|---|
| ส่งอะไรไปด้วย | ข้อมูลเพิ่มเติม (ข้อมูลเพื่อการแก้ไข หรือข้อมูลซ้ำ) | ข้อมูลเพื่อใช้ตรวจหาข้อผิดพลาด โดยทั่วไปขนาดเล็ก 8, 16 หรือ 32 บิต |
| ภาครับทำอะไรได้ | แก้ไขเองได้ ในตำแหน่งที่ถูกต้อง จากข้อมูลที่ส่งเพิ่มมา | ตรวจจับได้อย่างเดียว แก้ไขไม่ได้ |
| ถ้าพบข้อผิดพลาด | ซ่อมข้อมูลเอง ไม่ต้องขอใหม่ | ต้องร้องขอจากภาคส่งเพื่อให้ส่งข้อมูลมาใหม่ (คือ ARQ ใน บทที่ 11) |
| Overhead | ค่อนข้างสูง | ต่ำ |
การใช้งานของ FEC ไม่เป็นที่นิยมเท่าใดนัก เนื่องจากแพ็กเก็ตหรือเฟรมที่จะส่งมีขนาดใหญ่ขึ้นมากเมื่อต้องการส่งข้อมูลขนาดใหญ่ ยกเว้นกรณีการส่งที่มีเวลาหน่วงการแพร่กระจาย (propagation delay) ที่สูง เช่นการสื่อสารข้อมูลผ่านดาวเทียม — เพราะการขอส่งใหม่ผ่านดาวเทียมแพงมาก (RTT สูง) จึงคุ้มกว่าที่จะแบกข้อมูลซ่อมไปด้วยตั้งแต่แรก
วิธีที่จะกล่าวถึงต่อไปนี้ (พาริตี, พาริตีสองมิติ, checksum, CRC) เกือบทั้งหมดเป็นแบบ Feedback error control — คือบอกได้ว่า "เฟรมนี้เสีย" แต่บอกไม่ได้ว่าเสียตรงไหน ยกเว้นพาริตีสองมิติที่แก้ไขได้ในกรณีผิด 1 บิต
12.1.1การตรวจจับแบบหนึ่งบิตพาริตี (Single Parity Check)
การตรวจสอบแบบหนึ่งบิตพาริตีถือว่าเป็นการตรวจสอบที่ง่ายที่สุด หลักการคือ การเพิ่มข้อมูลขนาดหนึ่งบิตจากข้อมูลที่ต้องการตรวจสอบ เพื่อให้ได้ข้อมูลเป็น even (คู่) หรือ odd (คี่) ของบิต 1 ตามที่ต้องการ
ด้านรับนับจำนวนของบิต 1 ในข้อมูลที่ได้รับ เพื่อตรวจสอบว่าเป็น even หรือ odd ตามที่กำหนดหรือไม่ หากไม่ แสดงว่าข้อมูลที่รับมีความผิดพลาดเกิดขึ้น
| แบบ | เงื่อนไข | วิธีคิด parity bit |
|---|---|---|
| Even parity | จำนวน 1 ทั้งหมด (ข้อมูล + parity bit) เป็นเลขคู่ | ถ้าข้อมูลมี 1 เป็นจำนวนคู่ → parity = 0ถ้าเป็นจำนวนคี่ → parity = 1 |
| Odd parity | จำนวน 1 ทั้งหมด (ข้อมูล + parity bit) เป็นเลขคี่ | ถ้าข้อมูลมี 1 เป็นจำนวนคู่ → parity = 1ถ้าเป็นจำนวนคี่ → parity = 0 |
ข้อสอบใช้ odd parity — จำสั้น ๆ ว่า "odd = นับ 1 ทั้งหมดรวม parity bit แล้วต้องได้เลขคี่" ไม่ใช่ "ข้อมูลต้องมี 1 เป็นคี่"
ตัวอย่าง odd parity ทีละขั้น — ข้อมูล 101111101 (จากโจทย์ Q11)
- นับจำนวน
1ในข้อมูล:1,0,1,1,1,1,1,0,1→ มี1ทั้งหมด 7 ตัว - 7 เป็นเลขคี่อยู่แล้ว → ถ้าเติม
1จะกลายเป็น 8 (คู่) ผิดเงื่อนไข → จึงต้องเติม parity bit =0 - ได้ codeword =
101111101+0=1011111010(นับ 1 ได้ 7 ตัว = คี่ ✓)
ข้อจำกัด — จับได้เฉพาะความผิดพลาดจำนวนคี่
การตรวจสอบด้วยการใช้หนึ่งบิตพาริตี สามารถตรวจจับได้ในกรณีที่เกิดความผิดพลาดขึ้นเป็นจำนวนคี่เท่านั้น หากเกิดขึ้นเป็นจำนวนคู่จะไม่สามารถตรวจพบได้
หนังสือยกตัวอย่างข้อมูล 010111011 ที่ใช้การตรวจสอบแบบ even (มี 1 อยู่ 6 ตัว = คู่ ✓)
✔ ผิด 1 บิต → ตรวจจับได้
ภาครับได้รับเป็น 010101011 (บิตที่ 5 เปลี่ยนจาก 1 เป็น 0)
นับ 1 ได้ 5 ตัว = odd ซึ่งขัดกับเงื่อนไข even → ภาครับตรวจจับความผิดพลาดได้
✘ ผิด 2 บิต → ตรวจไม่พบ
ถ้าความผิดพลาดเกิดขึ้น 2 บิต จำนวน 1 ที่ได้จะยังคงเป็น even ตามเงื่อนไขของการตรวจสอบ
ทำให้การตรวจสอบด้วยการใช้แบบหนึ่งบิตพาริตีไม่สามารถตรวจจับได้
หนังสือหน้า 101 พิมพ์กรณี 2 บิตไว้เป็น 01010101 ซึ่งมีแค่ 8 บิต (น่าจะพิมพ์ตกไป 1 ตัว) ถ้าอยากได้ตัวอย่างที่ครบ 9 บิตให้ใช้อันนี้แทน — ต้นฉบับ 010111011 (มี 1 6 ตัว = คู่) แล้วพลิกบิตที่ 4 และบิตที่ 6 จะได้ 010010011 = 010010011 ซึ่งมี 1 อยู่ 4 ตัว = ยังคงเป็นคู่ → พาริตีผ่านฉลุย ทั้ง ๆ ที่ข้อมูลเพี้ยนไป 2 บิต นี่คือหลุมของ single parity (กดปุ่ม “ทำให้ 2 บิตผิด” ใน animation ข้างบนหลาย ๆ ครั้งก็จะเจอผลแบบเดียวกันทุกครั้ง)
ข้อดี / ข้อจำกัดโดยรวม
ข้อดี
- ทำได้โดยไม่จำเป็นต้องมีการจัดเก็บข้อมูล
- คำนวณค่าได้ระหว่างการส่งและรับข้อมูลแบบทันที (on-the-fly) จึงไม่เกิดเวลาหน่วง
- overhead แค่ 1 บิต
ข้อจำกัด
- เหมาะสำหรับระบบที่มีความผิดพลาดที่ต่ำ
- เหมาะกับกรณีที่หากเกิดความผิดพลาดจริง จะไม่มีผลรุนแรงกับระบบโดยรวม
- โดยรวมค่อนข้างมีประสิทธิภาพต่ำในการตรวจสอบความผิดพลาด
12.1.2การตรวจจับแบบพาริตีสองมิติ (Two-Dimensional Parity Checks)
เพื่อให้การตรวจจับมีประสิทธิภาพมากขึ้น การใช้การตรวจจับแบบพาริตีสองมิติเป็นวิธีหนึ่งในการแก้ปัญหาของการตรวจสอบความผิดพลาดที่มากกว่าหนึ่งบิตของข้อมูล
วิธีทำคือเพิ่มคอลัมน์สุดท้ายของแต่ละแถว และแถวล่างสุดใต้ข้อมูล
- คอลัมน์สุดท้ายของแต่ละแถว = ค่าบิตที่ใช้ในการตรวจสอบของแถวนั้น ๆ
- แถวล่างสุดใต้ข้อมูล = บิตตรวจสอบของในแต่ละคอลัมน์
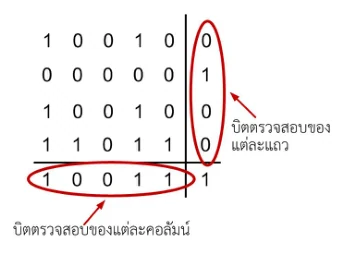
รูปที่ 12.3 กับรูปที่ 12.4 ใช้ตารางเดียวกัน แต่แถวที่ 2 ในรูปที่ 12.3 พิมพ์เป็น 0 0 0 0 0 คู่กับบิตตรวจสอบ 1 ซึ่งไม่ลงตัวกับพาริตีคู่ ถ้าดูรูปที่ 12.4 (ที่ใช้ตารางเดียวกัน) จะเห็นว่าแถวที่ 2 คือ 0 1 0 0 0 — มี 1 อยู่ 1 ตัว + บิตตรวจสอบ 1 = 2 ตัว (คู่ ✓) ให้ยึดตามรูปที่ 12.4 ตอนไล่ตัวเลข ไม่งั้นจะงงว่าทำไมพาริตีไม่ลงตัว
ตรวจได้แค่ไหน แก้ได้แค่ไหน
| จำนวนบิตที่ผิด | ตรวจจับ | แก้ไข | สังเกตยังไง |
|---|---|---|---|
| 1 บิต | ✔ ได้ทุกกรณี | ✔ ได้ทุกกรณี | ดูจุดตัดระหว่างแถวและคอลัมน์ที่มีค่าของพาริตีที่ผิดไป → กลับบิตนั้น |
| 2 บิต | ✔ ได้ | ✘ ไม่ได้ | มีแถวหรือคอลัมน์ผิดหลายจุด ไม่รู้ว่าจุดตัดไหนคือตัวจริง |
| 3 บิต | ✔ ได้ | ✘ ไม่ได้ | เหมือนกรณี 2 บิต |
| 4 บิต แบบทั่วไป | ✔ ได้ | ✘ ไม่ได้ | เหมือนกรณี 2 บิต |
| 4 บิต ที่วางเป็นรูปสี่เหลี่ยมพอดี | ✘ ตรวจไม่พบเลย | ทุกแถวและทุกคอลัมน์ที่เกี่ยวข้องโดนพลิกอย่างละ 2 บิต → พาริตีกลับมาเท่าเดิม | |
รูปที่ 12.4 เป็นตัวอย่างการตรวจสอบหาความผิดพลาดแบบพาริตีสองมิติในกรณี 1 ถึง 4 บิต โดย (a) เป็นการผิดพลาดแบบหนึ่งบิต สามารถตรวจสอบและแก้ไขได้ทุกกรณี ส่วน (b)–(d) เป็นการผิดพลาดตั้งแต่สองบิตขึ้นไป ซึ่งทั้งสามกรณีตรวจจับความผิดพลาดได้แต่แก้ไขไม่ได้ถูกต้อง ยกเว้นกรณีที่มีความผิดพลาดแบบ 4 บิตเป็นรูปสี่เหลี่ยมพอดี จะไม่สามารถตรวจสอบหาความผิดพลาดได้ (รูปที่ 12.4 (d))
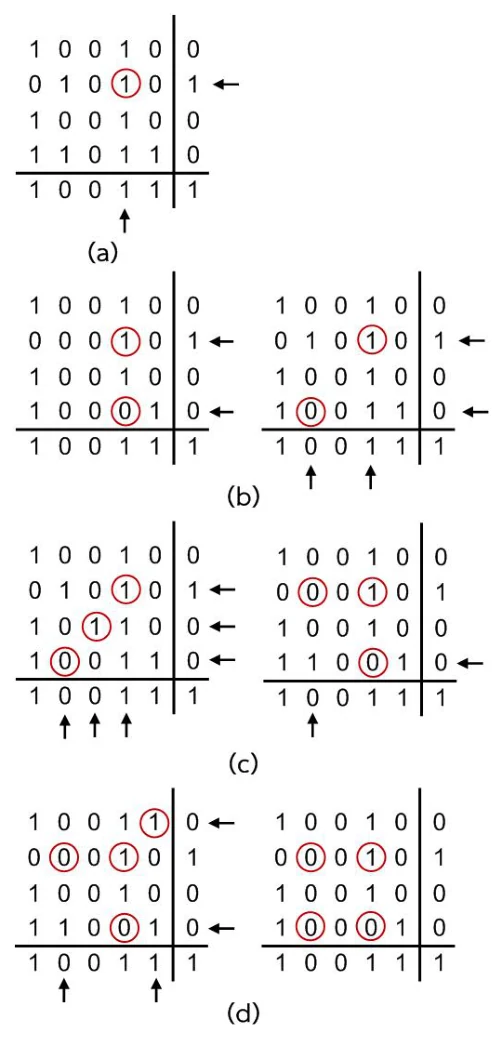
คำถามที่ชอบออกคือ "พาริตีสองมิติตรวจจับได้กี่บิต และแก้ไขได้กี่บิต" — คำตอบไม่ใช่ตัวเลขเดียวกัน! แก้ไขได้แค่ 1 บิต (จากจุดตัด) แต่ตรวจจับได้ตั้งแต่ 2, 3, 4 บิต โดยมีข้อยกเว้นเดียวคือ 4 บิตที่เรียงเป็นสี่เหลี่ยมพอดี ที่หลุดไปได้ทั้งหมด
12.1.3Checksum
ในการใช้ Checksum ขั้นตอนเป็นดังนี้
- ภาคส่ง — ข้อมูลที่จะส่งจะถูกแบ่งออกเป็นส่วน ๆ แต่ละส่วนมีขนาดเป็น n บิต (8 หรือ 16 บิตเป็นต้น)
- จากนั้นนำแต่ละส่วนบวกกันเพื่อคำนวณหาค่า Checksum ซึ่งค่าที่หาได้จะถูกส่งไปกับข้อมูลที่ส่ง
- ภาครับ — เมื่อได้รับข้อมูล จะแบ่งข้อมูลเป็นส่วน ๆ เช่นเดียวกับภาคส่ง เพื่อคำนวณค่า Checksum
- หากค่าที่คำนวณได้ตรงกับค่าของ Checksum ที่ได้รับจากภาคส่ง แสดงว่าข้อมูลมีความถูกต้อง มิฉะนั้นจะถือว่าข้อมูลที่ได้รับผิดพลาด อาจต้องร้องขอให้ภาคส่ง ส่งออกมาใหม่
หนังสือบอกแค่ว่า "นำแต่ละส่วนบวกกัน" แต่ในทางปฏิบัติ (IP / TCP / UDP header checksum) การบวกนี้เป็น 1's complement addition คือ (1) บวกกันแบบไบนารีปกติ (2) ถ้ามีตัวทดล้นออกจากบิตซ้ายสุด ให้เอาตัวทดนั้นวนกลับมาบวกที่บิตขวาสุด (wrap-around carry) (3) เมื่อบวกครบทุกคำแล้ว กลับบิตทั้งหมด (complement) จึงได้เป็นค่า Checksum ที่ส่งไป
ผลลัพธ์ที่สวยงามคือ ฝั่งรับเอาทุกคำรวมทั้ง Checksum มาบวกกันจะได้ 1 ทั้งหมด (11111111) เสมอถ้าไม่มีความผิดพลาด — animation ข้างล่างเดินให้ดูทีละขั้น
Checksum อ่อนกว่า CRC มาก เพราะการบวกไม่สนใจ "ลำดับ" ของคำ — ถ้าสองคำสลับที่กัน ผลบวกก็เท่าเดิม จับไม่ได้ และถ้ามีบิตหนึ่งกลาย 0→1 ในคำหนึ่ง พร้อมกับอีกบิตในตำแหน่งเดียวกันกลาย 1→0 ในอีกคำหนึ่ง ผลบวกก็เท่าเดิมอีก จึงเป็นเหตุผลว่าทำไมชั้น Data Link ถึงใช้ CRC ไม่ใช่ checksum
12.1.4โพลิโนเมียลโค้ด (Polynomial Codes / CRC)
โพลิโนเมียลโค้ด หรือเป็นที่รู้จักกันในชื่อของการตรวจสอบด้วยส่วนซ้ำซ้อนแบบวน (Cyclic Redundancy Check, CRC) มีข้อดีคือสามารถพัฒนาได้ด้วยวงจร Shift register อย่างง่าย ทำให้ได้รับการนำไปใช้กันอย่างแพร่หลายในการตรวจจับข้อผิดพลาด
1) แปลงบิตเป็นโพลิโนเมียล
หลักการทำงานคือ นำข้อมูลของเฟรมจำนวน k บิต เปรียบเสมือนค่าของข้อมูล k เทอมจาก xk−1 ถึง x0 โดยข้อมูลที่มีค่าโพลิโนเมียลสูงสุดจะมีกำลังเป็น xk−1 และบิตถัดไปจะมีค่าเป็น xk−2 จนกระทั่งถึงบิตสุดท้าย
110001 → x5 + x4 + x0
ตัวอย่างจากหนังสือหน้า 102 — บิตที่เป็น 1 เท่านั้นที่ปรากฏเป็นเทอม
เขียนกลับด้านคือ ดีกรีสูงสุดเป็น r → สตริงบิตยาว r+1 บิต เสมอ (นับตำแหน่ง xr, xr−1, …, x1, x0)
| โพลิโนเมียล G(x) | เทอมที่มี | สตริงบิต | ยาวกี่บิต | เติม 0 ท้ายข้อมูลกี่ตัว (r) |
|---|---|---|---|---|
| x3 + 1 | x³ , x⁰ | 1001 | 4 บิต | 3 |
| x4 + 1 | x⁴ , x⁰ | 10001 | 5 บิต | 4 |
| x8 + x2 + x + 1 | x⁸ , x² , x¹ , x⁰ | 1 0000 0111 | 9 บิต | 8 |
| x16 + x12 + x5 + 1 | x¹⁶ , x¹² , x⁵ , x⁰ | 1 0001 0000 0010 0001 | 17 บิต | 16 |
ระวัง! x³+1 ดีกรี 3 → ตัวหาร 4 บิต แต่ เติม 0 ท้ายข้อมูลแค่ 3 ตัว คนพลาดเพราะไปเติม 4 ตัวตามความยาวตัวหาร จำสูตร: จำนวน 0 ที่เติม = ความยาวตัวหาร − 1 = ดีกรีของ G(x) = r
2) เงื่อนไขของ generator polynomial
ก่อนส่งข้อมูล ภาคส่งและภาครับจะต้องตกลงในการใช้ generator polynomial G(X) ร่วมกันล่วงหน้า โดยที่บิตแรกและบิตสุดท้ายต้องมีค่าสัมประสิทธิ์เป็น 1
สมมุติว่าเราต้องการจัดการกับโค้ดที่มีขนาดของคำรหัสอยู่ที่ n บิต มีขนาดของข้อมูลเป็น k บิต จะทำให้มีขนาดของ Check bits เป็น n − k ในที่นี้เราจะให้เป็น (n, k) โดยที่ generator polynomial ของโค้ดที่ยกกำลัง n − k จะได้
| ตัวแปร | ความหมาย | ตัวอย่างจากข้อสอบ Q11(c) |
|---|---|---|
k | จำนวนบิตของข้อมูล M(X) | 10110011 → k = 8 |
r = n − k | จำนวน check bits = ดีกรีของ G(x) | G(x) = x³+1 → r = 3 |
n | ความยาว code word ที่ส่งจริง = k + r | 8 + 3 = 11 บิต |
G(X) | generator polynomial (สตริงบิตยาว r+1) | 1001 (4 บิต) |
3) ขั้นตอนการคำนวณของภาคส่ง
- ขั้นที่ 1 — ข้อมูลที่จะส่ง
M(X)จะถูกคูณด้วย Xr ทำให้ได้จำนวนของบิต 0 จำนวนเท่ากับ r ที่ตำแหน่งท้ายของข้อมูล - ขั้นที่ 2 — ผลของการหารด้วย G(X) จะทำให้ได้ผลเป็น
Q(X)และมีเศษเป็น R(X) สอดคล้องกับสมการ
Xr · M(X) = Q(X) · G(X) ⊕ R(X)(12.1)
Xr · M(X) ⊕ R(X) = Q(X) · G(X)(12.2) - ขั้นที่ 3 — เศษของการหารจะถูกบวกกับ Xr · M(X) จะทำให้ได้
T(X) = Xr · M(X) ⊕ R(X)(12.3)
เพื่อเป็น code word ที่จะส่ง
เนื่องจากค่ายกกำลังของเศษมีค่าต่ำกว่าค่าสูงสุดของ r ดังนั้นการนำค่าของเศษที่เกิดขึ้นไปวางในตำแหน่งที่ Xr·M(X) มีค่าเป็นศูนย์ จึงเสมือนการบวกด้วยบิตพาริตีเพื่อใช้ในการตรวจสอบที่จำนวนเท่ากับ r
การตรวจสอบของด้านรับ ทำโดยการนำค่าของ T(X) หารด้วย G(X) หากพบว่าค่าของเศษ R(X) มีค่าเป็นศูนย์ แสดงว่าข้อมูลที่ได้รับถูกต้อง มิฉะนั้นแสดงว่ามีความผิดพลาดเกิดขึ้นระหว่างการสื่อสาร
การ "หาร" ในที่นี้ไม่ใช่การหารเลขปกติ แต่เป็น modulo-2 division ซึ่งกฎมีแค่ 3 ข้อ
- การลบ = XOR (
0⊕0=0,0⊕1=1,1⊕0=1,1⊕1=0) - ไม่มีตัวทด ไม่มีการยืม — แต่ละหลักคิดแยกกันหมด
- ดูแค่บิตซ้ายสุดของหน้าต่าง — ถ้าเป็น
1ผลหารบิตนั้นเป็น1แล้ว XOR ด้วย G · ถ้าเป็น0ผลหารเป็น0แล้ว XOR ด้วย0000(เท่ากับเลื่อนหน้าต่างไป 1 ช่องเฉย ๆ)
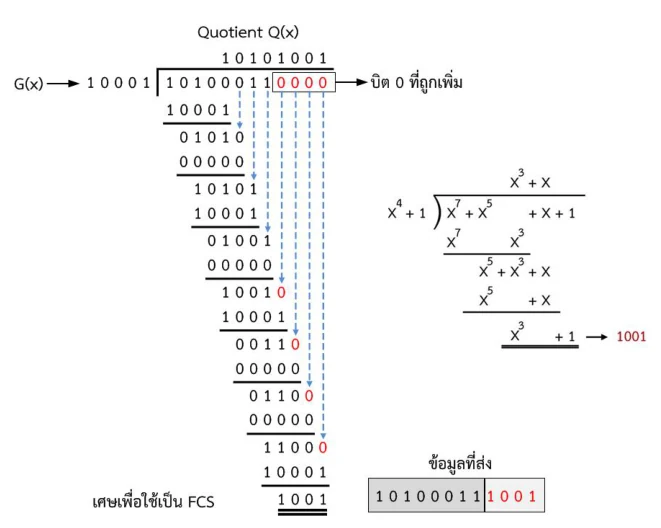
ตัวอย่าง 12.1 จากหนังสือ
สมมุติให้ข้อมูลที่ต้องการส่งเป็น 10100011 ถ้าค่าของ G(x) เป็น x⁴ + 1
- G(x) = x⁴+1 → สตริงบิต
10001(5 บิต) →r = 4 - เติม 0 ท้ายข้อมูล 4 ตัว:
10100011+0000=101000110000 - หาร modulo-2 ด้วย
10001→ ได้เศษ frame check sequence (FCS) =1001 - ภาคส่งจะนำค่าที่ได้ต่อท้ายข้อมูลเพื่อส่งไปในช่องสัญญาณ →
10100011+1001=101000111001
หนังสือย้ำว่า “การหารโดยใช้ค่าไบนารีและสัมประสิทธิ์ของ x จากการหารแบบโพลิโนเมียลมีค่าเท่ากัน (1001)” — คือจะคิดเป็นบิตหรือคิดเป็นพหุนามก็ได้คำตอบเดียวกัน ให้คิดเป็นบิตเพราะเร็วกว่ามาก
  101000110000   <- M ต่อ 0 จำนวน r=4 ตัว
  10001          <- XOR  (q=1)
  -----
  001010110000
   00000         <- XOR  (q=0)
   -----
   01010110000
    10001        <- XOR  (q=1)
    -----
    0010010000
     00000       <- XOR  (q=0)
     -----
     010010000
      10001      <- XOR  (q=1)
      -----
      00011000
       00000     <- XOR  (q=0)
       -----
       0011000
        00000    <- XOR  (q=0)
        -----
        011000
         10001   <- XOR  (q=1)
         -----
         01001
          1001   <- R = FCS (4 บิต)

  T = 10100011 1001 = 101000111001
ฝั่งรับตรวจยังไง
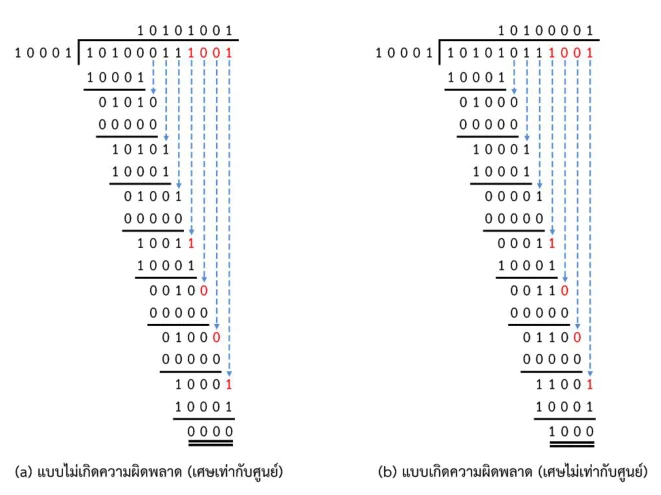
เมื่อภาครับได้รับข้อมูล จะเห็นว่าหากไม่มีความผิดพลาดเกิดขึ้น จะทำให้เศษหลังการคำนวณเป็นศูนย์ (รูปที่ 12.6 (a)) แต่หากเกิดความผิดพลาดขึ้น เศษหลังการคำนวณจะไม่เป็นศูนย์ (รูปที่ 12.6 (b)) ซึ่งในกรณีนั้นมีความผิดพลาดขนาดหนึ่งบิตเกิดขึ้นที่บิตห้าของข้อมูลที่ส่ง
ทั้งสองกรณีใช้ตัวอย่าง 12.1 ต่อเนื่องกัน (ข้อมูล 10100011, G(x) = x⁴+1 → 10001, FCS = 1001 จึงส่ง T = 101000111001) ไล่การหารเองทีละบรรทัดตามนี้ก่อนแล้วค่อยไปเทียบกับรูป
(a) กรณีไม่เกิดความผิดพลาด — เศษต้องเป็นศูนย์
ภาครับได้ T = 101000111001 ครบถ้วนตามที่ส่ง แล้วหารด้วย G(x) = 10001 ตัวเดิม (ไม่ต้องเติม 0 ท้ายอีกแล้ว เพราะ FCS ถูกต่อท้ายมาให้แล้ว)
  101000111001   <- T ที่ได้รับ = ข้อมูล 10100011 ต่อด้วย FCS 1001
  10001          <- XOR  (q=1)
  -----
  001010111001
   00000         <- XOR  (q=0)
   -----
   01010111001
    10001        <- XOR  (q=1)
    -----
    0010011001
     00000       <- XOR  (q=0)
     -----
     010011001
      10001      <- XOR  (q=1)
      -----
      00010001
       00000     <- XOR  (q=0)
       -----
       0010001
        00000    <- XOR  (q=0)
        -----
        010001
         10001   <- XOR  (q=1)
         -----
         00000   <- เศษ R(X) = 0000

  เศษ = 0000 → ข้อมูลที่ได้รับถูกต้อง ส่งขึ้นเลเยอร์ถัดไป
(b) กรณีเกิดความผิดพลาด — เศษไม่เป็นศูนย์
คราวนี้เกิดความผิดพลาดขนาด หนึ่งบิตที่บิตที่ห้าของข้อมูลที่ส่ง — 10100011 1001 กลายเป็น 10101011 1001 ภาครับซึ่งไม่รู้เรื่องอะไรเลย ก็เอาสิ่งที่ได้รับมาหารด้วย 10001 เหมือนเดิม
  101010111001   <- T ที่ได้รับ — บิตที่ 5 เพี้ยนจาก 0 เป็น 1
  10001          <- XOR  (q=1)
  -----
  001000111001
   00000         <- XOR  (q=0)
   -----
   01000111001
    10001        <- XOR  (q=1)
    -----
    0000011001
     00000       <- XOR  (q=0)
     -----
     000011001
      00000      <- XOR  (q=0)
      -----
      00011001
       00000     <- XOR  (q=0)
       -----
       0011001
        00000    <- XOR  (q=0)
        -----
        011001
         10001   <- XOR  (q=1)
         -----
         01000   <- เศษ R(X) = 1000

  เศษ = 1000 ≠ 0000 → มีความผิดพลาด! ทิ้งเฟรมนี้ แล้วให้ ARQ ขอส่งใหม่
- ไปเติม 0 ท้ายอีกรอบ — ฝั่งรับหารตัวที่ได้รับมาทั้งก้อน (ข้อมูล + FCS) ไม่มีการเติม 0 เพิ่ม การเติม 0 เกิดเฉพาะฝั่งส่งเท่านั้น
- คิดว่าเศษไม่เป็นศูนย์แปลว่ารู้ว่าผิดตรงไหน — ไม่ใช่ CRC บอกได้แค่ว่า "เฟรมนี้เสีย" ซ่อมไม่ได้ ต้องขอส่งใหม่ (เป็น Feedback error control ตามหัวข้อ 12.1)
- ลืมว่าเศษยาว r บิตเสมอ — บรรทัดสุดท้ายของ (a) คือ
00000ซึ่งอ่านเศษเป็น0000(4 บิต) ไม่ใช่ 5 บิต - เศษไม่เป็นศูนย์ ≠ ผิดหนึ่งบิตเสมอไป — ในตัวอย่างนี้บังเอิญเป็น 1 บิต แต่เศษค่าเดียวกันอาจมาจากรูปแบบความผิดพลาดอื่นก็ได้
ผลหาร (Q) ของกรณี (a) คือ 10101001 ส่วนกรณี (b) คือ 10100001 — ตรงกับตัวเลขที่พิมพ์ไว้เหนือเส้นหารในรูปที่ 12.6 ทั้งสองฝั่ง ถ้าไล่แล้วได้ไม่ตรง แปลว่ามี XOR ผิดไปบรรทัดหนึ่ง ให้ย้อนกลับไปดูบรรทัดที่ผลหารเป็น 0 (บรรทัดที่ XOR ด้วย 00000) เพราะเป็นจุดที่คนข้ามบ่อยที่สุด
CRC จับความผิดพลาดแบบไหนได้บ้าง
ในการใช้งานของโพลิโนเมียลโค้ด การเลือก G(X) มีผลอย่างมาก กับการตรวจสอบข้อผิดพลาดที่เกิดขึ้น หากกล่าวโดยสรุปจะได้ว่า การใช้งาน G(X) ที่จำนวนบิตเป็น R จะทำให้สามารถตรวจสอบเงื่อนไขต่อไปนี้ ซึ่งถือเป็นข้อดีของการใช้ CRC
✔ ตรวจจับได้ทุกกรณี
- ค่าของความผิดพลาดแบบ 1 บิต
- ค่าของความผิดพลาดแบบ 2 บิต
- ค่าของความผิดพลาดที่เป็นจำนวนคี่
- ค่าของความผิดพลาดแบบ burst ที่น้อยกว่า R บิต ในทุกกรณี
△ ตรวจจับได้ แต่ไม่ทุกกรณี
- ค่าของความผิดพลาดแบบ burst ที่มากกว่าหรือเท่ากับ R บิต
โดย R คือจำนวนบิตของ G(X) — เช่น 1001 มี R = 4 จึงจับเบิร์สต์ที่สั้นกว่า 4 บิตได้ทุกกรณี
นอกจากนี้ CRC ยังง่ายต่อการพัฒนาในด้านฮาร์ดแวร์และซอฟต์แวร์ ยิ่งไปกว่านั้นหากใช้ฮาร์ดแวร์ในการตรวจสอบจะสามารถเพิ่มความเร็วในการประมวลผลที่เร็วขึ้น
ตารางที่ 12.1 — CRC มาตรฐานที่นิยมใช้
| ชื่อ | โพลิโนเมียล | สตริงบิต | แอปพลิเคชัน |
|---|---|---|---|
| CRC-8 | x8 + x2 + x + 1 | 1 0000 0111 | ATM header |
| CRC-10 | x10 + x9 + x5 + x4 + x2 + 1 | 110 0011 0101 | ATM AAL |
| CRC-16 | x16 + x12 + x5 + 1 | 1 0001 0000 0010 0001 | HDLC |
| CRC-32 | x32 + x26 + x22 + x16 + x12 + x11 + x10 + x8 + x7 + x4 + x2 + x + 1 | 33 บิต | LAN (อีเทอร์เน็ตที่เราใช้ทุกวัน) |
คอลัมน์ "สตริงบิต" เป็นการแปลงจากคอลัมน์โพลิโนเมียลตามกฎในหัวข้อ 1) — ลองไล่นับดีกรีเองดูสัก 1 อันจะช่วยให้จำวิธีแปลงได้แน่นขึ้น
- เติม 0 ผิดจำนวน —
x³+1→ ตัวหาร 4 บิต แต่เติม 0 แค่ 3 ตัว - ไปหารแบบเลขฐานสิบ / มีตัวยืม — ต้อง XOR ทีละหลัก ไม่มีทด ไม่มียืม
- ตอบแค่เศษ — คำตอบสุดท้ายคือ "ข้อมูลเดิม + เศษ" (
10110011+111=10110011111) ไม่ใช่111เฉย ๆ และไม่ใช่ "ข้อมูลที่เติม 0 แล้ว + เศษ" ด้วย - ลืมว่าเศษต้องยาว r บิตเสมอ — ถ้าคำนวณแล้วได้
11ต้องเขียนเป็น011(เติม 0 นำหน้าให้ครบ 3 บิต) - เมื่อบิตซ้ายสุดของหน้าต่างเป็น 0 แล้วข้ามไปเลย — ข้ามได้ แต่ต้องจำว่าผลหารบิตนั้นเป็น 0 และหน้าต่างเลื่อนไปแค่ 1 ช่อง (ไม่ใช่เลื่อนไปหาบิต 1 ตัวถัดไปทีเดียว)
12.2สรุป
Data Link Layer ถือเป็นส่วนที่มีความสำคัญอย่างมากในการสื่อสารระหว่างโนดต่อโนด ซึ่งนอกเหนือจากการจัดการข้อมูลที่ได้รับให้อยู่ในรูปของเฟรมแล้ว ยังมีหน้าที่ในการตรวจสอบความผิดพลาดที่อาจเกิดขึ้นอันเนื่องมาจากการสื่อสารในช่องสัญญาณ
ในบทนี้ (และกลุ่มบทที่ 10–12) เราได้ให้ความสำคัญกับการทำงานของ Data Link Layer และการทำงานในด้านต่าง ๆ ตั้งแต่การจัดการเฟรม, การทำงานของมัลติเพล็กซิง, การส่งข้อมูลแบบ ARQ แบบ stop-and-wait, selective-repeat และ go-back-N ARQ ซึ่งเป็นพื้นฐานสำคัญในการส่งข้อมูลระหว่างโนดที่ติดกัน และเป็นพื้นฐานสำคัญในการทำงานของโพรโตคอลในเลเยอร์ถัดไป นอกจากนี้ เพื่อให้สามารถตรวจหาความผิดพลาดที่อาจเกิดขึ้น การใช้งานการแก้ไขความผิดพลาด (Error correction) และการตรวจจับความผิดพลาด (Error detection) ได้นำเสนอในบทนี้เช่นกัน
| วิธี | overhead | ตรวจจับ | แก้ไข | ใช้ที่ไหน |
|---|---|---|---|---|
| Single parity | 1 บิต | ผิดจำนวนคี่เท่านั้น | ✘ | RS-232 / อะซิงโครนัส |
| 2-D parity | 1 แถว + 1 คอลัมน์ | 1–4 บิต (ยกเว้น 4 บิตรูปสี่เหลี่ยม) | ✔ เฉพาะ 1 บิต | หน่วยความจำ / สื่อการสอน |
| Checksum | 8/16/32 บิต | ปานกลาง | ✘ | IP / TCP / UDP header |
| CRC | r บิต (เท่าดีกรี G) | แข็งแรงที่สุด (1 บิต, 2 บิต, จำนวนคี่, burst < R บิต) | ✘ | อีเทอร์เน็ต, HDLC, ATM |
และเมื่อการตรวจสอบไม่ผ่าน สิ่งที่ Data Link Layer ทำก็มีอยู่อย่างเดียว — ปั๊ม "Reject" แล้วโยนเฟรมนั้นทิ้ง ไม่ส่งขึ้นเลเยอร์ถัดไป จากนั้นค่อยให้กลไก ARQ ของ บทที่ 11 จัดการขอส่งใหม่ต่อไป
12.3คำถามท้ายบท (พร้อมเฉลย)
คำถามท้ายบทชุดนี้ครอบคลุมบทที่ 10–12 ทั้งกลุ่ม กดที่หัวข้อเพื่อดูเฉลย ลองทำเองก่อนแล้วค่อยเปิดจะได้ผลที่สุด
ข้อ 1 — หากข้อมูลเป็น 00011111111001111101000111111111111000011111 จงแสดงข้อมูลที่ส่งหลังจากทำ Bit Stuffing
กฎ (จากบทที่ 10): เมื่อพบบิต 1 ติดกันครบ 5 ตัว ให้ภาคส่งแทรกบิต 0 เข้าไป 1 บิต ทันที เพื่อป้องกันไม่ให้ข้อมูลที่จะส่งไปซ้ำกับ flag 01111110
ไล่ทีละกลุ่ม:
| ส่วนของข้อมูลเดิม | จำนวน 1 ติดกัน | หลังทำ stuffing |
|---|---|---|
000 | — | 000 |
11111111 | 8 ตัว | 111110111 (แทรกหลังตัวที่ 5) |
00 | — | 00 |
11111 | 5 ตัว | 111110 |
0 1 000 | — | 01000 |
111111111111 | 12 ตัว | 11111011111011 (แทรก 2 ครั้ง) |
0000 | — | 0000 |
11111 | 5 ตัว | 111110 |
คำตอบ (ข้อมูลเดิม 44 บิต → แทรก 0 ไป 5 ตัว → ได้ 49 บิต):
ถ้าโจทย์ให้ใส่ flag ด้วย ก็ครอบหัวท้ายเป็น 01111110 + ข้อมูลข้างบน + 01111110 (flag ไม่ต้องทำ stuffing)
ข้อ 2 — จงบอกหน้าที่ของการทำงานของ Data Link Layer
- รองรับการสื่อสารระหว่างโนดกับโนด (node-to-node) เช่นแบบ point-to-point หรือ point-to-multipoint
- แปลงข้อมูลให้อยู่ในรูปดิจิทัล พร้อมเพิ่มเฮดเดอร์ เช่น MAC address ของภาครับและภาคส่ง
- เพิ่มส่วนท้าย (trailer) เพื่อใช้ในการตรวจสอบความผิดพลาด — ก็คือ CRC ในบทนี้นั่นเอง
- จัดทุกอย่างให้อยู่ในรูปของเฟรม (framing) ก่อนส่งต่อไปยัง Physical Layer และเมื่อภาครับได้รับเฟรม จะนำเฮดเดอร์ออก พร้อมตรวจสอบข้อผิดพลาด ก่อนส่งขึ้นไปในเลเยอร์ถัดไป
- การสื่อสารแบบประสานเวลา (Synchronous) และไม่ประสานเวลา (Asynchronous)
- การทำมัลติเพล็กซิง (FDM / TDM / WDM) และ สวิตชิ่ง
- การควบคุมการส่งผ่านข้อมูล (flow control) และการส่งซ้ำเมื่อผิดพลาด (ARQ)
จำง่าย ๆ 4 คำ: Framing · Addressing (MAC) · Error detection · Flow & error control
ข้อ 3 — จุดประสงค์ของการทำมัลติเพล็กซิงคืออะไร
คำตอบตรง ๆ จากหนังสือ: การทำมัลติเพล็กซ์เป็นการจัดการในการใช้ทรัพยากรร่วมกัน เพื่อประสิทธิภาพของการใช้สูงสุด โดยทรัพยากรที่กล่าวถึงในที่นี้คือแบนด์วิดท์ ซึ่งมีหน่วยเป็น เฮิร์ตซ์ (Hz) ในการส่งแบบแอนะล็อก และ บิตต่อวินาที (bps) ในการส่งแบบดิจิทัล
กล่าวคือ ถ้าให้ผู้ใช้คนเดียวครองสายทั้งเส้น สายจะว่างเปล่าเป็นส่วนใหญ่ การมัลติเพล็กซ์จึงแบ่งช่องสัญญาณออกเป็นส่วนย่อยให้หลายคนใช้พร้อมกัน โดยทำได้ 3 รูปแบบพื้นฐาน: FDM (แบ่งความถี่), WDM (แบ่งความยาวคลื่น — ใยแก้วนำแสง) และ TDM (แบ่งเวลา)
ข้อ 4 — จงหาแบนด์วิดท์ที่ต้องใช้ในการส่งข้อมูลเสียง 5 ช่องสัญญาณ แต่ละช่องต้องการแบนด์วิดท์ 4 KHz และต้องใช้ Guard band ที่ 500 Hz โดยใช้ FDM
โจทย์ให้มา: จำนวนช่อง = 5 · แบนด์วิดท์ต่อช่อง = 4 kHz · guard band = 500 Hz = 0.5 kHz
หนังสือบทที่ 10 ไม่ได้ให้สูตรนับ guard band ไว้ตรง ๆ แต่หลักที่ใช้กันทั่วไปคือ guard band วางไว้ "ระหว่าง" ช่องเท่านั้น ดังนั้น N ช่อง → guard band N−1 แถบ (5 ช่องมีรอยต่อ 4 รอย) ถ้าอาจารย์กำหนดให้มี guard band ที่ขอบทั้งสองด้านด้วย ก็จะเป็น 6 แถบ ให้ดูโจทย์/รูปที่ให้มาประกอบ
คำตอบ: 22 kHz (22,000 Hz)
ถ้านับ guard band 6 แถบ (มีขอบด้วย) จะได้ 20 + 3 = 23 kHz — เขียนวิธีคิดให้ชัดว่านับกี่แถบ อาจารย์ให้คะแนนที่วิธีคิดมากกว่าตัวเลข
ข้อ 5 — จากการทำงานของ Stop-and-Wait, Selective Repeat และ Go-Back-N จงยกตัวอย่างแอปพลิเคชันที่เหมาะสมในการใช้การส่งข้อมูลแต่ละแบบ
| แบบ | ลักษณะเด่น | แอปพลิเคชันที่เหมาะ + เหตุผล |
|---|---|---|
| Stop-and-Wait W = 1 |
ง่ายที่สุด · ฝั่งส่งบัฟเฟอร์ 1 เฟรม · ฝั่งรับไม่ต้องบัฟเฟอร์เลย · แต่ประสิทธิภาพต่ำเมื่อ propagation delay สูง | งานที่ระยะทางสั้นและอุปกรณ์มีหน่วยความจำน้อย เช่น การสื่อสารกับเซนเซอร์/ไมโครคอนโทรลเลอร์ (IoT), การคุยกับอุปกรณ์ผ่านพอร์ตอนุกรม RS-232, การส่งคำสั่งสั้น ๆ ที่ต้องรอผลตอบทีละคำสั่ง |
| Go-Back-N W > 1 |
ส่งต่อเนื่องได้ · ฝั่งรับไม่ต้องบัฟเฟอร์ (ทิ้งเฟรมที่ไม่ตรงลำดับ) · แต่ถ้าเฟรมหายต้องส่งซ้ำทั้ง window | ลิงก์ที่อัตราความผิดพลาดต่ำ แต่ต้องการ throughput สูงและอยากประหยัดหน่วยความจำฝั่งรับ เช่น การส่งไฟล์ผ่านสาย LAN ในองค์กร หรือลิงก์ HDLC ที่คุณภาพสายดี |
| Selective Repeat W > 1 + บัฟเฟอร์ |
ส่งซ้ำเฉพาะเฟรมที่หาย · ประสิทธิภาพดีที่สุด · แต่ทั้งสองฝั่งต้องมีบัฟเฟอร์ N เฟรม และต้องจัดลำดับใหม่ | ลิงก์ที่เวลาหน่วงสูงหรือมีความผิดพลาดบ่อย ซึ่งการส่งซ้ำทั้ง window จะแพงมาก เช่น การสื่อสารผ่านดาวเทียม, ลิงก์ไร้สาย/ข้ามประเทศ, และการดาวน์โหลดไฟล์ใหญ่ผ่าน TCP (TCP SACK ทำงานตามแนวคิดนี้) |
หลักตอบ: ยิ่ง propagation delay สูง ยิ่งต้องใช้ window ใหญ่ และ ยิ่งหน่วยความจำน้อย ยิ่งต้องใช้แบบที่ไม่ต้องบัฟเฟอร์
ข้อ 6 ⭐ — ข้อมูล 10100101 ถ้าค่าของ G(x) เป็น x³ + 1 จงหาค่าที่ส่งออกจากภาคส่ง พร้อมทั้งแสดงการคำนวณของข้อมูลที่รับได้ที่ภาครับ
ขั้นที่ 0 — แปลง G(x) เป็นบิต
G(x) = x³ + 1 → มีเทอม x³ และ x⁰ → 1 0 0 1 = 1001 (4 บิต) → r = 3
ขั้นที่ 1 — คูณด้วย Xr (เติม 0 ท้าย 3 ตัว)
10100101 → 10100101000 (11 บิต)
ขั้นที่ 2 — หาร modulo-2 ด้วย 1001
  10100101000   <- M ต่อ 0 จำนวน 3 ตัว
  1001          <- XOR  (q=1)
  ----
  00110101000
   0000         <- XOR  (q=0)
   ----
   0110101000
    1001        <- XOR  (q=1)
    ----
    010001000
     1001       <- XOR  (q=1)
     ----
     00011000
      0000      <- XOR  (q=0)
      ----
      0011000
       0000     <- XOR  (q=0)
       ----
       011000
        1001    <- XOR  (q=1)
        ----
        01010
         1001   <- XOR  (q=1)
         ----
         0011
          011   <- R = เศษ 3 บิต

  ผลหาร Q = 10110011 (ไม่ต้องใช้ในคำตอบ)
ขั้นที่ 3 — ต่อเศษท้ายข้อมูลเดิม
10100101 + 011 = 10100101011
ค่าที่ส่งออกจากภาคส่ง (11 บิต = k 8 + r 3)
คำตอบคือ 10100101011 ไม่ใช่ 10100101000011 — เศษไปแทนที่ 0 ที่เติมไว้ ไม่ได้ต่อท้ายเพิ่ม
การคำนวณที่ภาครับ (กรณีไม่มีความผิดพลาด) — นำ T ที่รับได้หารด้วย G(x) ตรง ๆ ไม่ต้องเติม 0 อีก
  10100101011
  1001          (q=1)
  ----
  00110101011
   0000         (q=0)
   ----
   0110101011
    1001        (q=1)
    ----
    010001011
     1001       (q=1)
     ----
     00011011
      0000      (q=0)
      ----
      0011011
       0000     (q=0)
       ----
       011011
        1001    (q=1)
        ----
        01001
         1001   (q=1)
         ----
         0000
          000   <- เศษ = 0 → ข้อมูลถูกต้อง ✓
เศษ = 000 → ภาครับสรุปว่าข้อมูลไม่มีความผิดพลาด แล้วตัด 3 บิตท้ายทิ้ง เหลือข้อมูล 10100101 ส่งขึ้นเลเยอร์ถัดไป
ถ้ามีความผิดพลาด เช่นบิตที่ 5 เพี้ยน (10101101011) หารแล้วจะได้เศษ 001 ≠ 0 → ภาครับทิ้งเฟรมและร้องขอให้ส่งใหม่ (ลองกดโหมด "ภาครับ — มี 1 บิตผิด" ใน animation ข้างบนดูได้)
ข้อ 7 — ขั้นตอนการทำงานของ Circuit switching มีอะไรบ้าง
การทำงานของเซอร์กิท สวิตซิ่ง แบ่งออกเป็น 3 ขั้นตอน
- การสร้างการเชื่อมต่อ (Connection establishment) — ก่อนส่งข้อมูลใด ๆ การเชื่อมต่อระหว่างต้นทางและปลายทางจะต้องถูกสร้างขึ้นก่อน โดยโนดสวิตชิ่งจะจัดสรรทรัพยากรให้ เช่น ในการทำงานแบบ FDM จะกำหนดช่องความถี่ที่จะใช้ให้กับโนดต้นทาง
- การส่งข้อมูล (Data transfer) — เมื่อได้รับการตอบรับการสร้างการเชื่อมต่อจากปลายทางแล้ว ต้นทางสามารถเริ่มส่งข้อมูลได้ทันที
- การยกเลิกการเชื่อมต่อ (Connection release) — เมื่อสิ้นสุดการสื่อสาร เช่นปลายทางวางสาย โนดที่อยู่ระหว่างทางจะยกเลิกทรัพยากรที่จัดสรรไว้ เพื่อให้ผู้ใช้รายอื่นสามารถใช้งานได้
ตัวอย่างการสื่อสารแบบเซอร์กิท สวิตซิ่ง ได้แก่ PPP (ใช้ในโมเด็ม, DSL, ไฟเบอร์ออปติก) และ ISDN (ระบบโทรศัพท์แบบดิจิทัล)
ข้อ 8 — เปรียบเทียบข้อดีและข้อด้อยของการส่งแบบ Circuit switching กับ Packet switching ความเหมาะสมของข้อมูลในการส่งแต่ละประเภท
| คุณสมบัติ | เซอร์กิท สวิตซิ่ง | เวอร์ชวล เซอร์กิท | Datagram |
|---|---|---|---|
| การสร้างเส้นทาง | ต้องสร้างก่อน | ต้องสร้างก่อน | ไม่จำเป็น |
| การจัดสรรทรัพยากร | จองตลอดเวลา | จองตลอดเวลา | ใช้ร่วมกัน |
| ลำดับการรับแพ็กเก็ต | เรียงลำดับ | เรียงลำดับ | อาจไม่เรียง |
| ขนาดเฮดเดอร์ | ไม่มีแพ็กเก็ต | เล็ก (ใช้ ID) | ใหญ่ (ใช้ IP) |
| ความเหมาะสม | เสียง/วิดีโอ Real-time | QoS สูง | อินเทอร์เน็ตทั่วไป |
ตารางที่ 3.1 จากหนังสือ (บทที่ 3)
Circuit switching
ข้อดี — จองทรัพยากรไว้แล้วจึงส่งได้ทันทีเป็นชุดเดียว ตามเส้นทางที่สร้างไว้ ทำให้เวลาหน่วงคงที่ ไม่มีการรอคิว ข้อมูลถึงเรียงลำดับเสมอ เหมาะกับงานเรียลไทม์
ข้อด้อย — ต้องครองทรัพยากรตลอดเวลาแม้ไม่มีการรับส่งข้อมูล จึงสิ้นเปลือง และมีเวลารอตอนสร้างการเชื่อมต่อก่อนเริ่มส่ง
Packet switching
ข้อดี — ไม่มีการจัดสรรทรัพยากรให้ผู้ใช้เฉพาะ ทำให้มีการใช้ทรัพยากรร่วมกันสูงขึ้น แบบ Datagram ยังไม่ต้องสร้างการเชื่อมต่อล่วงหน้า ทำให้ส่งข้อมูลได้เร็วกว่าเมื่อมีข้อมูลปริมาณน้อย
ข้อด้อย — แต่ละแพ็กเก็ตมีเวลาหน่วงเพิ่มขึ้นจากการรอช่องสัญญาณว่าง · Datagram อาจได้รับไม่เป็นลำดับ ภาครับต้องจัดเรียงใหม่ · เฮดเดอร์ใหญ่กว่า
ความเหมาะสม: เสียง/วิดีโอเรียลไทม์ (โทรศัพท์, วิดีโอคอล) → circuit switching เพราะต้องการ delay คงที่ · งานที่ต้องการ QoS สูงแต่ยังเป็นแพ็กเก็ต → virtual circuit (ATM) · ข้อมูลทั่วไปบนอินเทอร์เน็ตและ LAN (เว็บ, อีเมล, ไฟล์) → datagram packet switching เพราะทราฟฟิกมาเป็นช่วง ๆ (bursty) การจองสายไว้จะเปลืองเปล่า
12.4ทดสอบตัวเองก่อนออกจากบทนี้
1011001 ใช้ odd parity — parity bit ที่ต้องเติมคือบิตอะไร011011001 มีบิต 1 อยู่ 4 ตัว ซึ่งเป็นเลขคู่ · odd parity ต้องการให้จำนวน 1 ทั้งหมด รวม parity bit เป็นเลขคี่ → ต้องเติม 1 เพื่อให้ได้ 5 ตัว → codeword = 10110011x⁸ + x² + x + 1 — ตัวหารยาวกี่บิต และต้องเติม 0 ต่อท้ายข้อมูลกี่ตัว1 0000 0111 (x⁸, x², x¹, x⁰ เป็น 1 ที่เหลือเป็น 0) · จำนวน 0 ที่เติม = r = ดีกรี = 8 ตัว ไม่ใช่ 9 — นี่คือกับดักที่คนพลาดบ่อยที่สุดของข้อ CRC- Odd parity = จำนวน
1ทั้งหมด รวม parity bit ต้องเป็นเลขคี่ (ข้อสอบใช้ odd ไม่ใช่ even) - Single parity จับได้เฉพาะความผิดพลาดจำนวนคี่ ผิด 2 บิตหลุดทันที
- 2-D parity: แก้ไขได้ 1 บิต · ตรวจจับได้ 2–4 บิต · ยกเว้น 4 บิตรูปสี่เหลี่ยม = จับไม่ได้เลย
- CRC = หาร modulo-2 = XOR ไม่มีตัวทดไม่มียืม
- ดีกรี r → ตัวหาร r+1 บิต → เติม 0 ท้ายข้อมูล r ตัว → เศษยาว r บิต (x³+1 →
1001→ เติม000→ เศษ 3 บิต) - คำตอบสุดท้าย = ข้อมูลเดิม + เศษ เช่น
10110011+111=10110011111 - ฝั่งรับ: หาร T ด้วย G ตรง ๆ ไม่ต้องเติม 0 → เศษ = 0 แปลว่าถูกต้อง
- ฝึกจริงต่อที่ ข้อสอบ Q11 และทบทวน bit stuffing ที่ บทที่ 10